
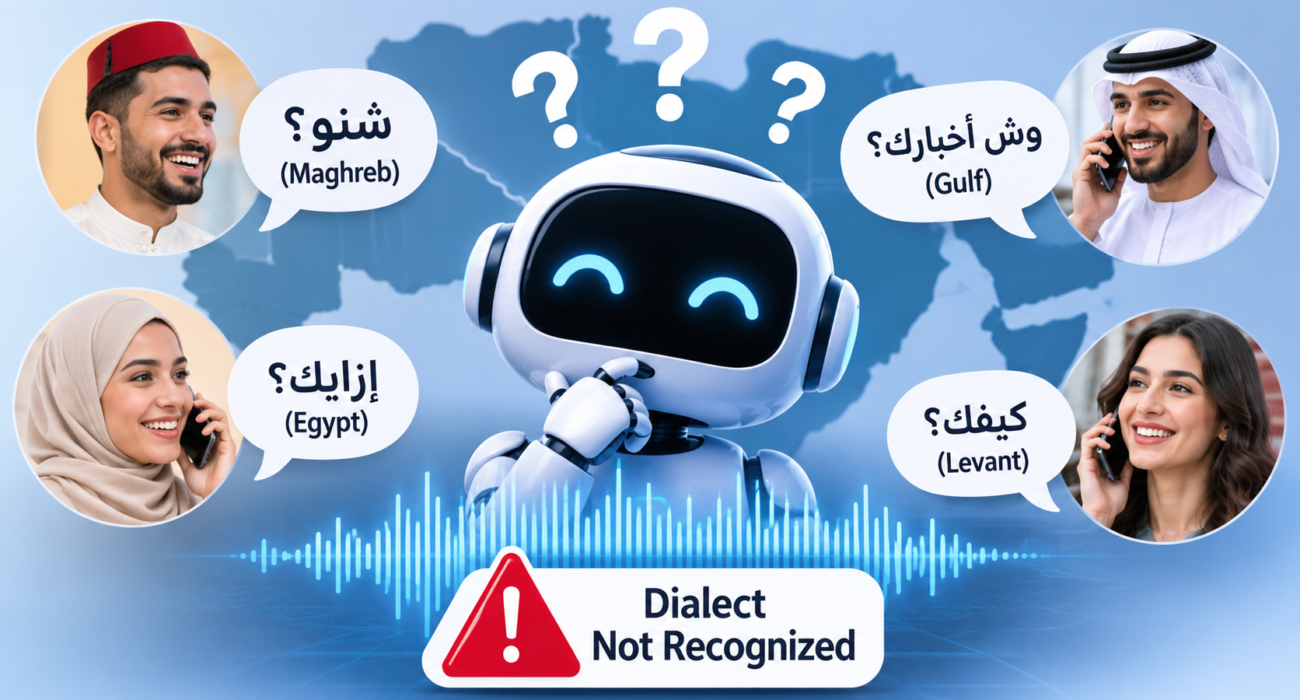
يمثل هذا التنوع تحدياً كبيراً لأنظمة الذكاء الاصطناعي. فقد يحقق نموذج التعرف على الكلام باللغة العربية، الذي تم تدريبه بشكل أساسي على العربية الفصحى الحديثة، نتائج جيدة عند معالجة نشرات الأخبار الرسمية أو الخطابات، لكنه قد يواجه صعوبات في فهم المحادثات اليومية واللهجات الإقليمية والتعبيرات المحلية.
ومع الانتشار المتزايد للمساعدات الصوتية وتطبيقات تحويل الكلام إلى نص ومنصات خدمة العملاء الآلية وأدوات الذكاء الاصطناعي الحوارية، أصبحت القدرة على فهم اللهجات العربية أكثر أهمية من أي وقت مضى. إن بناء أنظمة ذكاء اصطناعي صوتية موثوقة باللغة العربية يتطلب أكثر من مجرد جمع تسجيلات صوتية باللغة العربية، بل يحتاج إلى مجموعات بيانات صوتية تمثل الطريقة التي يتحدث بها الناس فعلياً.
في هذا المقال، نستعرض أهم مجموعات اللهجات العربية، ونوضح أسباب صعوبة التعرف عليها بالنسبة لأنظمة الذكاء الاصطناعي، كما نتناول دور البيانات الصوتية عالية الجودة والتعليقات اللغوية الدقيقة في تحسين تقنيات التعرف على الكلام باللغة العربية.
1. اللغة العربية لغة غنية باللهجات المتنوعة
من أبرز خصائص اللغة العربية التعايش بين العربية الفصحى الحديثة والعديد من اللهجات المحلية المستخدمة في الحياة اليومية.
تُستخدم العربية الفصحى الحديثة بشكل شائع في الكتابة الرسمية والتعليم ووسائل الإعلام والأخبار والاتصالات الرسمية والخطابات العامة. أما المحادثات اليومية، فتتم غالباً باستخدام اللهجات المحلية التي قد تختلف بشكل كبير عن اللغة العربية الفصحى.
وقد ينتقل المتحدثون باللغة العربية بين الفصحى ولهجاتهم المحلية وفقاً للموقف والجمهور والموضوع. وتُعرف هذه الظاهرة باسم التناوب اللغوي أو التغير في مستوى اللغة المستخدم.
وبالنسبة لأنظمة التعرف على الكلام، فهذا يعني أن اللغة التي تتم معالجتها قد تتغير بشكل ملحوظ من تسجيل إلى آخر، بل وحتى داخل الجملة الواحدة.
الفرق بين العربية الفصحى الحديثة والعربية المحكية
توفر العربية الفصحى الحديثة مرجعاً لغوياً موحداً نسبياً. أما اللهجات المحكية، فتعكس الهويات الإقليمية والتأثيرات الثقافية وعادات التواصل اليومية.
فعلى سبيل المثال، قد تحتوي الجملة العربية الرسمية على مفردات وتراكيب نحوية نادراً ما تُستخدم في المحادثات العفوية. كما قد ينطق المتحدث بعض الكلمات بطريقة مختلفة أو يستخدم تعبيراً مختلفاً تماماً حسب منطقته.
وتكمن أهمية هذا الاختلاف في أن نموذج الذكاء الاصطناعي الذي يتم تدريبه بشكل أساسي على اللغة العربية الرسمية قد لا يتمكن من التعرف على المفردات والنطق وتراكيب الجمل التي يستخدمها المتحدثون باللغة العربية في حياتهم اليومية.
2. أهم مجموعات اللهجات العربية
تُصنف اللهجات العربية عادةً وفقاً للتشابهات الجغرافية واللغوية. ورغم فائدة هذه التصنيفات، فإن كل مجموعة تضم أيضاً لهجات محلية واختلافات بين المدن والمناطق والمجتمعات.
اللهجات المغاربية: المغربية والجزائرية والتونسية
تُستخدم اللهجات العربية المغاربية في شمال أفريقيا، وخاصة في المغرب والجزائر وتونس، بالإضافة إلى أجزاء من ليبيا وموريتانيا.
تشترك الدارجة المغربية والعربية الجزائرية والعربية التونسية في العديد من الخصائص التاريخية واللغوية، لكنها تتميز أيضاً بمفردات وأنماط نطق وتعبيرات خاصة بكل منها.
وتتأثر هذه اللهجات بعدة لغات، من بينها اللغات الأمازيغية والفرنسية، بالإضافة إلى الإسبانية ولغات أخرى حسب المنطقة.
تشمل أبرز التحديات التي تواجه أنظمة الذكاء الاصطناعي ما يلي:
- أنماط نطق تختلف عن العربية الفصحى الحديثة.
- مفردات وتعبيرات محلية قد لا تكون موجودة في مجموعات البيانات العربية القياسية.
- الاستخدام المتكرر للكلمات الفرنسية أو كلمات من لغات أجنبية أخرى في المحادثات اليومية.
- اختلافات في النطق بين المتحدثين من مدن ومناطق مختلفة.
- محدودية توفر مجموعات بيانات صوتية كبيرة ودقيقة التعليق لبعض اللهجات.
فعلى سبيل المثال، تتضمن اللهجة التونسية بشكل متكرر كلمات فرنسية في المحادثات اليومية. وقد يستخدم المتحدث كلمات عربية وفرنسية بشكل طبيعي داخل الجملة نفسها، مما يضيف تحديات جديدة لأنظمة التعرف الآلي على الكلام.
اللهجة المصرية
تُعد اللهجة المصرية واحدة من أكثر اللهجات العربية انتشاراً وشهرة، ويرجع ذلك جزئياً إلى تأثير السينما والتلفزيون والموسيقى ووسائل الإعلام الرقمية المصرية.
وعلى الرغم من حضورها القوي في المحتوى الإعلامي، فإن اللهجة المصرية لا تزال تختلف عن العربية الفصحى الحديثة في النطق والمفردات والقواعد.
يجب على أنظمة الذكاء الاصطناعي تعلم التعرف على التعبيرات المصرية اليومية وتراكيب الجمل العامية والاختلافات في النطق بين المتحدثين. ولا تستطيع بيانات التدريب التي تعتمد حصرياً على العربية الرسمية تمثيل هذه الخصائص بشكل كامل.
اللهجات الشامية
تُستخدم اللهجات الشامية في دول مثل لبنان وسوريا والأردن وفلسطين.
وعلى الرغم من اشتراك هذه اللهجات في العديد من الخصائص اللغوية، فإنها ليست متطابقة. ويمكن للاختلافات في المفردات والنطق والتعبيرات المحلية أن تؤثر في طريقة تفسير أنظمة التعرف على الكلام للمحادثات.
كما تتضمن اللهجات الشامية اختلافات إقليمية واجتماعية. فقد يحقق النموذج نتائج جيدة مع إحدى اللهجات، لكنه يقدم نصوصاً أقل دقة عند التعامل مع لهجة أخرى.
اللهجات الخليجية
تشمل اللهجات الخليجية الأنواع المحكية المستخدمة في دول مثل المملكة العربية السعودية والإمارات العربية المتحدة والكويت وقطر والبحرين وسلطنة عُمان.
وتتميز هذه اللهجات بأنماط نطق ومفردات وتعبيرات خاصة بها. كما توجد اختلافات بين المجتمعات الحضرية والريفية وبين الدول المجاورة.
وبالنسبة لمطوري الذكاء الاصطناعي، فإن جمع البيانات الصوتية من مناطق خليجية متعددة أمر مهم لتجنب بناء نماذج تحقق أداءً جيداً مع مجموعة محددة من المتحدثين فقط.
اللهجة السودانية واللهجات الإقليمية الأخرى
تساهم اللهجة السودانية وغيرها من اللهجات الإقليمية أيضاً في التنوع اللغوي للعالم الناطق بالعربية.
وقد تتضمن هذه اللهجات مفردات مميزة وأنماط نطق خاصة وتأثيرات من اللغات المحلية. كما أن تمثيلها في مجموعات بيانات تقنيات التعرف على الكلام قد يكون محدوداً مقارنة باللهجات التي تحظى باهتمام بحثي أكبر.
إن إدراج هذه اللهجات ضمن مجموعات البيانات الصوتية العربية يساعد على تحسين التغطية اللغوية وجعل أنظمة الذكاء الاصطناعي أكثر فائدة لشريحة أوسع من المتحدثين.
3. لماذا تمثل اللهجات العربية مشكلة لأنظمة الذكاء الاصطناعي؟
لا يقتصر تنوع اللهجات العربية على اختلاف اللهجات أو طرق النطق، بل يؤثر في عدة عناصر أساسية من تقنيات التعرف الآلي على الكلام، بما في ذلك المفردات والنطق والقواعد والنمذجة اللغوية.
اختلاف المفردات للتعبير عن المعنى نفسه
قد يستخدم المتحدثون باللغة العربية كلمات مختلفة تماماً للتعبير عن الفكرة نفسها حسب المنطقة التي ينتمون إليها.
وقد يواجه نموذج التعرف على الكلام، الذي تم تدريبه على لهجة واحدة، مفردات غير مألوفة عند معالجة لهجة أخرى. وإذا لم تتضمن بيانات التدريب أمثلة كافية لهذه التعبيرات، فقد يستبدلها النموذج بكلمات أكثر شيوعاً أو ينتج نصوصاً غير دقيقة.
وتصبح هذه المشكلة أكثر أهمية عندما يكون النموذج مخصصاً لخدمة المستخدمين في عدة دول ناطقة باللغة العربية.
اختلافات النطق واللهجات المحلية
يمكن أن تجعل اختلافات النطق من الصعب على أنظمة الذكاء الاصطناعي تحديد الكلمات بشكل صحيح.
فقد تختلف اللهجات العربية في طريقة نطق بعض الحروف الساكنة وتحقيق الحركات الصوتية وتغير الأصوات أثناء الكلام المتصل. وحتى داخل اللهجة نفسها، يمكن أن تختلف لهجات المتحدثين وسرعة كلامهم وطريقة نطقهم للكلمات.
ويجب على نماذج التعرف على الكلام تعلم التمييز بين الاختلافات اللغوية المهمة والتغيرات الطبيعية بين المتحدثين.
التناوب بين العربية واللغات الأخرى
يمزج العديد من المتحدثين باللغة العربية بشكل طبيعي بين العربية والفرنسية أو الإنجليزية، خاصة في بيئات العمل والتعليم والتكنولوجيا والتواصل الرقمي اليومي.
وتُعرف هذه الممارسة باسم التناوب اللغوي، وهي تمثل تحدياً إضافياً لأنظمة التعرف على الكلام.
فعلى سبيل المثال، قد يستخدم متحدث تونسي مصطلحاً تقنياً بالفرنسية داخل جملة عربية، بينما قد يدمج متحدث من منطقة أخرى مصطلحات باللغة الإنجليزية.
وقد يفشل النموذج الذي تم تدريبه على تسجيلات عربية فقط في التعرف على هذه الكلمات، أو يحولها بشكل خاطئ إلى تعبيرات عربية ذات نطق مشابه.
الاختلافات في القواعد وبنية الجمل
قد تختلف اللهجات العربية عن العربية الفصحى الحديثة في التراكيب النحوية وتصريف الأفعال والضمائر وبناء الجمل.
وتؤثر هذه الاختلافات في كيفية ارتباط الكلمات ببعضها البعض وفي طريقة تفسير الجمل. وقد يواجه النموذج اللغوي الذي يعتمد بشكل كبير على قواعد العربية الفصحى صعوبة في فهم التعبيرات العامية الطبيعية تماماً بالنسبة للمتحدثين الأصليين.
محدودية بيانات التدريب وعدم توازنها
يُعد توفر مجموعات البيانات الصوتية العربية وتوزيعها من أكبر التحديات في هذا المجال.
فبعض اللهجات ممثلة بشكل أفضل من غيرها في مجموعات التسجيلات الصوتية المتاحة للعامة. وإذا حصل النموذج على آلاف الساعات من التسجيلات الخاصة بلهجة واحدة، مقابل كمية قليلة جداً من البيانات الخاصة بلهجة أخرى، فقد تتأثر نتائجه بهذا الاختلال.
ويؤدي ذلك إلى مشكلة في التغطية اللغوية، حيث قد يبدو النموذج دقيقاً أثناء الاختبارات، لكنه يظل غير موثوق بالنسبة للمتحدثين الذين لم يتم تمثيل لهجاتهم بشكل كافٍ أثناء التدريب.
4. لماذا لا تكفي بيانات التدريب باللغة العربية الفصحى الحديثة؟
تُعد العربية الفصحى الحديثة ضرورية للعديد من التطبيقات، لكنها لا تستطيع تمثيل التنوع الكامل للغة العربية المحكية.
لنتخيل نظاماً للنسخ الصوتي التلقائي تستخدمه شركة لمعالجة مكالمات خدمة العملاء. فقد يتحدث العملاء باللهجة التونسية أو المغربية أو المصرية أو الشامية أو الخليجية. كما قد ينتقلون بين اللهجات والعربية الفصحى أثناء المحادثة نفسها.
إذا كان النموذج قد تعلم بشكل أساسي من تسجيلات الأخبار الرسمية، فقد يواجه صعوبة في التعامل مع:
- التعبيرات غير الرسمية والمفردات العامية.
- اختلافات النطق واللهجات الإقليمية.
- المحادثات السريعة والعفوية.
- الكلمات الأجنبية المدمجة داخل الجمل العربية.
- الجمل غير المكتملة والتكرار والترددات الطبيعية أثناء الكلام.
ولهذا السبب، يجب أن يشمل تطوير أنظمة الذكاء الاصطناعي الصوتي باللغة العربية بيانات من الكلام الرسمي والمحادثات اليومية معاً. وتساعد استراتيجية التدريب المتوازنة النماذج على فهم الفرق بين طريقة كتابة اللغة العربية وطريقة استخدامها فعلياً في الحياة اليومية.
5. أهمية مجموعات البيانات الصوتية المخصصة للهجات العربية
تُعد مجموعات البيانات الصوتية عالية الجودة من أهم الأسس لبناء أنظمة موثوقة للتعرف على الكلام باللغة العربية.
وبدلاً من التعامل مع العربية باعتبارها فئة لغوية موحدة، ينبغي للمطورين مراعاة التنوع اللغوي للمستخدمين المستهدفين عند جمع بيانات التدريب وإعدادها.
تمثيل مختلف الدول والمناطق
ينبغي أن تتضمن مجموعة البيانات الصوتية العربية الممثلة للواقع متحدثين من مناطق جغرافية مختلفة. وبحسب متطلبات المشروع، يمكن أن تشمل اللهجات المغربية والجزائرية والتونسية والليبية والمصرية والسودانية والشامية والخليجية.
ليس من الضروري بالضرورة إدراج جميع اللهجات في كل مشروع، بل الهدف هو ضمان أن تعكس مجموعة البيانات المستخدمين المستهدفين والظروف الحقيقية التي سيعمل فيها نظام الذكاء الاصطناعي.
إدراج فئات متنوعة من المتحدثين
لا يكفي الاهتمام بتغطية اللهجات فقط، بل يجب أن تراعي مجموعات البيانات الصوتية أيضاً الاختلافات بين المتحدثين.
تشمل الجوانب المهمة ما يلي:
- الفئات العمرية المختلفة وأساليب التحدث.
- التنوع بين الجنسين.
- الخلفيات الحضرية والريفية.
- مستويات التعليم المختلفة ومدى التعرض للغات.
- المتحدثون الأصليون وغير الأصليين، عندما يكون ذلك مناسباً للمشروع.
يساعد هذا التنوع على تقليل مخاطر تطوير أنظمة تعمل بشكل جيد مع فئة محدودة من المستخدمين فقط.
تسجيل المحادثات الطبيعية
تُعد التسجيلات الصوتية النظيفة داخل الاستوديو مفيدة لبعض مهام التدريب، لكن الكلام في العالم الحقيقي غالباً ما يكون أكثر تعقيداً.
فقد تحتوي التسجيلات الحوارية على مقاطعات وضوضاء في الخلفية وتداخل الأصوات والترددات والتعبيرات غير الرسمية. ويساعد إدراج أمثلة مناسبة لهذه الظروف المطورين على تقييم أداء أنظمتهم خارج بيئات التسجيل الخاضعة للرقابة.
6. لماذا تُعد دقة النسخ الصوتي والتعليق على البيانات أمراً مهماً؟
لا يمثل جمع الملفات الصوتية سوى جزء واحد من عملية بناء مجموعة بيانات صوتية موثوقة. إذ يجب أيضاً تحويل التسجيلات إلى نصوص مكتوبة وإضافة التعليقات والوسوم إليها بطريقة متسقة.
يتطلب نسخ الكلام العربي اتخاذ قرارات دقيقة بشأن الإملاء وتمثيل اللهجات وعلامات الترقيم والكلمات الأجنبية والترددات أثناء الكلام.
وبالنسبة لمشاريع الذكاء الاصطناعي التي تركز على اللهجات، يجب أن تحدد إرشادات التعليق بوضوح كيفية تمثيل التعبيرات العامية كتابةً.
تحديد اللهجة
يمكن إضافة معلومات خاصة باللهجة إلى كل تسجيل أو مقطع صوتي. وبحسب متطلبات المشروع، يمكن أن تحدد هذه الوسوم الدولة أو المنطقة أو فئة لهجية أكثر تحديداً.
تساعد هذه المعلومات المطورين على تنظيم مجموعات البيانات وتحليل أداء النماذج وتحديد اللهجات التي تحتاج إلى بيانات تدريب إضافية.
تمييز المتحدثين
تهدف عملية تمييز المتحدثين إلى تحديد الشخص الذي يتحدث والوقت الذي يتحدث فيه. وتُعد هذه العملية مفيدة بشكل خاص للتسجيلات التي تضم عدة مشاركين، مثل المقابلات والاجتماعات ومحادثات خدمة العملاء.
إن الجمع بين النسخ الصوتي الدقيق وتسميات المتحدثين يوفر بيانات تدريب وتقييم أكثر ثراءً لتقنيات التعرف على الكلام.
إرشادات متسقة للنسخ الصوتي
قد يكتب مختلف المعلقين التعبير اللهجي نفسه بطرق مختلفة، خاصة عندما لا يوجد نظام إملائي موحد لتلك اللهجة.
تساعد إرشادات التعليق الواضحة والمتخصصون المدربون من المتحدثين الأصليين وإجراءات ضمان الجودة على تقليل هذه الاختلافات.
وبالنسبة لمشاريع التعلم الآلي، تُعد الاتساقية أمراً أساسياً. فقد تؤدي التعليقات غير الموحدة بشكل كافٍ إلى إدخال أخطاء في بيانات التدريب وجعل تقييم النماذج أقل موثوقية.
7. كيف يمكن لمطوري الذكاء الاصطناعي تحسين التعرف على الكلام باللغة العربية؟
يتطلب تحسين التعرف على الكلام باللغة العربية الجمع بين جمع بيانات أفضل والخبرة اللغوية وتطوير النماذج والتقييم المنهجي.
ويمكن أن تساعد عدة استراتيجيات على تحقيق ذلك:
1. تدريب النماذج على لهجات عربية متعددة
يجب أن تعكس بيانات التدريب اللهجات التي يُتوقع أن يدعمها التطبيق. وينبغي للمطورين عدم افتراض أن النموذج المدرب على نوع واحد من العربية سيكون قادراً تلقائياً على فهم جميع اللهجات الأخرى.
2. استخدام تسجيلات المتحدثين الأصليين
توفر التسجيلات التي يشارك فيها متحدثون أصليون أمثلة قيّمة على النطق الحقيقي والمفردات وأنماط الكلام الطبيعية. وينبغي أن يمثل المشاركون مناطق وأساليب تحدث مختلفة.
3. إدراج الكلام الذي يمزج بين اللغات
عندما يكون ذلك مناسباً، يجب أن تتضمن مجموعات البيانات أمثلة واقعية على المزج بين العربية والفرنسية والإنجليزية أو لغات أخرى. ويُعد ذلك مهماً بشكل خاص للتطبيقات الموجهة إلى المجتمعات متعددة اللغات.
4. تطبيق التعليق الصوتي التفصيلي
يمكن أن تساعد النصوص المكتوبة وتسميات المتحدثين ووسوم اللهجات والطوابع الزمنية والبيانات الوصفية الأخرى على تحسين قابلية استخدام مجموعات البيانات ودعم تقييم أكثر تفصيلاً للنماذج.
5. تقييم كل لهجة بشكل منفصل
قد يخفي الاعتماد على نتيجة دقة إجمالية واحدة اختلافات كبيرة بين مجموعات اللهجات. لذلك، ينبغي للمطورين تقييم أداء النموذج بشكل منفصل لكل لهجة مستهدفة.
يُعد معدل الخطأ في الكلمات (Word Error Rate – WER) أحد المقاييس الشائعة لتقييم أنظمة التعرف الآلي على الكلام. ومع ذلك، يتطلب تقييم اللغة العربية أيضاً قواعد دقيقة لتوحيد النصوص، لأن اختلاف طرق الكتابة يمكن أن يؤثر في النتائج.
كما يمكن أن يوفر معدل الخطأ في الأحرف (Character Error Rate – CER) ومجموعات التقييم المخصصة للهجات والمراجعة البشرية معلومات إضافية حول أداء النماذج.
8. التطبيقات العملية للتعرف على اللهجات العربية
أصبح فهم اللهجات العربية مهماً في مجموعة متزايدة من تطبيقات تقنيات التعرف على الكلام.
المساعدات الصوتية والذكاء الاصطناعي الحواري
يجب أن تكون المساعدات الصوتية قادرة على فهم التعبيرات وأنماط النطق التي يستخدمها جمهورها المستهدف. ويمكن أن يؤدي دعم لهجات عربية متعددة إلى جعل التفاعلات أكثر طبيعية وسهولة في الاستخدام.
أتمتة خدمة العملاء
تحتاج الشركات التي تعمل في أسواق عربية متعددة إلى أنظمة صوتية قادرة على فهم العملاء من دول مختلفة. ويمكن للتعرف على الكلام المراعي للهجات أن يحسن نسخ المكالمات والدعم الآلي وتحليل تفاعلات العملاء.
نسخ المحتوى الإعلامي وإنتاج الترجمة النصية
غالباً ما تتضمن البرامج التلفزيونية والبودكاست والمقابلات ومقاطع الفيديو عبر الإنترنت اللغة العربية العامية. ويمكن أن يساعد التعرف الدقيق على اللهجات في النسخ الصوتي وإنشاء الترجمة النصية وإنشاء أرشيفات إعلامية قابلة للبحث.
تقنيات الرعاية الصحية والتعليم
يجب أن تراعي التطبيقات الصوتية المستخدمة في مجالي الرعاية الصحية والتعليم الطريقة الطبيعية التي يتواصل بها الأشخاص. ويمكن أن تساعد التغطية الأفضل للهجات على جعل الواجهات الصوتية أكثر سهولة لمختلف المجتمعات، مع ضرورة مراعاة متطلبات الخصوصية والسلامة والتحقق المتخصص حسب طبيعة كل تطبيق.
9. تطوير ذكاء اصطناعي صوتي عربي أفضل مع Arabica AI Voice
يبدأ تطوير أنظمة ذكاء اصطناعي صوتية عربية موثوقة بفهم الأشخاص الذين تقف أصواتهم وراء التسجيلات. ويجب تمثيل اللهجات المختلفة واللهجات المحلية وأساليب التحدث ومزيج اللغات في البيانات المستخدمة لتدريب نماذج التعرف على الكلام وتقييمها.
في Arabica AI Voice، نركز على تقديم خدمات البيانات اللغوية العربية التي تدعم تقنيات الكلام ومشاريع تطوير الذكاء الاصطناعي.
يمكن لخدماتنا دعم المشاريع التي تحتاج إلى:
- جمع البيانات الصوتية باللغة العربية: تسجيلات مصممة وفقاً للهجات المحددة وخصائص المتحدثين ومتطلبات المشروع.
- النسخ الصوتي باللغة العربية: تحويل المحتوى العربي المنطوق إلى نصوص مكتوبة، بما في ذلك متطلبات النسخ الخاصة باللهجات.
- التعليق على البيانات الصوتية: وسوم منظمة وبيانات وصفية تجعل التسجيلات الصوتية أكثر فائدة لمشاريع التعلم الآلي.
- تغطية اللهجات العربية: أساليب لجمع البيانات تراعي التنوع اللغوي للمجتمعات الناطقة باللغة العربية.
- خدمات بيانات الصور والبيانات متعددة الوسائط: دعم إضافي لإعداد البيانات لمشاريع الذكاء الاصطناعي التي تتطلب أكثر من البيانات الصوتية.
سواء كنت تعمل على تطوير نموذج للتعرف على الكلام باللغة العربية أو مساعد صوتي أو تطبيق ذكاء اصطناعي حواري متعدد اللغات، فإن جودة بيانات التدريب ومدى تمثيلها للواقع يمكن أن يحدثا فرقاً كبيراً.
اكتشف خدماتنا اللغوية باللغة العربية وخدمات النسخ الصوتي والتعليق على البيانات لمعرفة كيف يمكننا دعم مشروعك.
10. الأسئلة الشائعة حول اللهجات العربية والذكاء الاصطناعي
كم عدد اللهجات العربية الموجودة؟
لا يوجد عدد محدد ومتفق عليه عالمياً للهجات العربية. فاللغة العربية تضم العديد من اللهجات الإقليمية والمحلية التي تُصنف عادةً ضمن مجموعات رئيسية مثل اللهجات المغاربية والمصرية والشامية والخليجية. وتتضمن كل مجموعة اختلافات إضافية بين الدول والمجتمعات.
هل يستطيع الذكاء الاصطناعي فهم جميع اللهجات العربية؟
تدعم بعض أنظمة الذكاء الاصطناعي عدة لهجات عربية، لكن مستوى الأداء يختلف حسب النموذج وبيانات التدريب والتطبيق المستهدف. وقد يواجه النظام الذي تم تدريبه بشكل أساسي على العربية الفصحى الحديثة صعوبة في فهم الكلام العامي واللهجات الإقليمية الأقل تمثيلاً.
لماذا تُعد الدارجة المغربية صعبة على أنظمة التعرف على الكلام؟
تتميز الدارجة المغربية بمفردات خاصة وأنماط نطق مميزة وتأثيرات لغوية متعددة. كما تتضمن بشكل متكرر عناصر من اللغة الفرنسية واللغات الأمازيغية. ويمكن أن تجعل هذه الخصائص معالجتها صعبة بالنسبة للنماذج التي تم تدريبها على العربية الرسمية أو اللهجات الأخرى.
ما الفرق بين العربية الفصحى الحديثة والعربية اللهجية؟
العربية الفصحى الحديثة هي الشكل اللغوي الموحد المستخدم في الكتابة الرسمية والتعليم والاتصالات الرسمية. أما العربية اللهجية فتشير إلى اللهجات الإقليمية المستخدمة في المحادثات اليومية. ويكمن الاختلاف بينهما في النطق والمفردات والقواعد.
ما نوع البيانات المطلوبة لتدريب نماذج التعرف على الكلام باللغة العربية؟
تستفيد نماذج التعرف على الكلام باللغة العربية من تسجيلات صوتية متنوعة تمثل اللهجات والمتحدثين وظروف التسجيل المستهدفة. كما تُعد النصوص المكتوبة الدقيقة وتسميات المتحدثين والبيانات الخاصة باللهجات وإرشادات التعليق المتسقة عناصر مهمة.
لماذا يُعد التعليق على البيانات حسب اللهجة أمراً مهماً؟
يساعد التعليق المخصص للهجات على تحديد الاختلافات اللغوية وتوفير وسوم أكثر دقة لتدريب أنظمة الذكاء الاصطناعي وتقييمها. كما يساعد المطورين على معرفة المجالات التي تحقق فيها نماذجهم نتائج جيدة والمجالات التي قد تحتاج إلى بيانات إضافية.
هل تكفي العربية الفصحى الحديثة لتدريب نموذج ذكاء اصطناعي صوتي عربي؟
يعتمد ذلك على التطبيق المستهدف. فقد تكون العربية الفصحى الحديثة كافية للأنظمة التي تركز على الكلام الرسمي، لكن التطبيقات المصممة لفهم المحادثات اليومية تحتاج عادةً إلى بيانات صوتية من اللهجات العربية أيضاً.
الخاتمة: تنوع اللهجات العربية يمثل تحدياً في بيانات الذكاء الاصطناعي
يُعد تنوع اللهجات العربية من أهم الجوانب التي يجب أخذها في الاعتبار عند تطوير أنظمة موثوقة للتعرف على الكلام باللغة العربية. فالاختلافات في المفردات والنطق والقواعد والتناوب بين اللغات تجعل من الصعب على نماذج الذكاء الاصطناعي فهم جميع المتحدثين باللغة العربية بالاعتماد على أسلوب تدريب موحد واحد.
يبدأ الحل بتحسين جودة البيانات. فالتسجيلات الصوتية التي تمثل الواقع بشكل مناسب، والنسخ الصوتي المخصص للهجات، والتعليق المتسق على البيانات، والتقييم الذي يشمل مجموعات مختلفة من المتحدثين، كلها عوامل تساعد على إنشاء تقنيات صوتية عربية أكثر موثوقية وشمولاً.
ومع استمرار ارتفاع الطلب على تقنيات الذكاء الاصطناعي الصوتي باللغة العربية، سيصبح الاستثمار في البيانات اللغوية عالية الجودة أمراً ضرورياً لبناء أنظمة لا تفهم العربية الرسمية فحسب، بل تفهم أيضاً اللغة التي يستخدمها الناس في حياتهم اليومية.
هل تعمل على تطوير مشروع للذكاء الاصطناعي الصوتي باللغة العربية؟
تواصل مع Arabica AI Voice لمناقشة احتياجاتك المتعلقة بجمع البيانات الصوتية والنسخ الصوتي باللغة العربية وخدمات التعليق على البيانات.