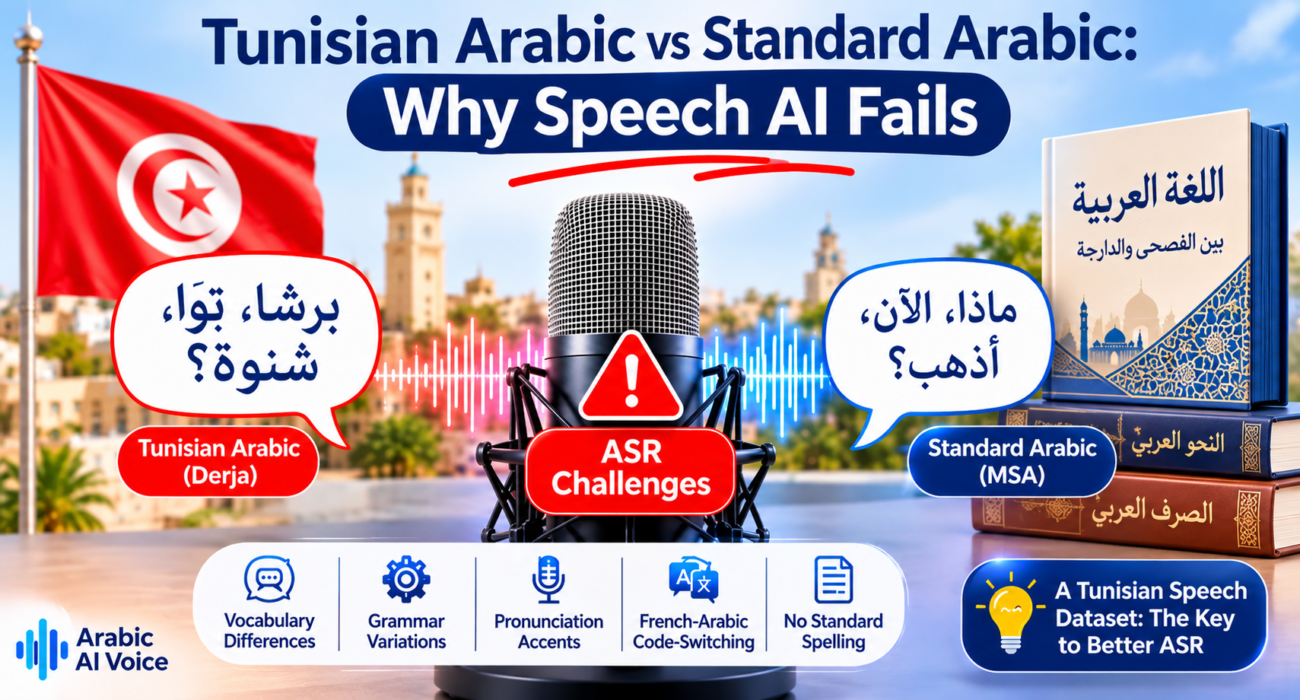
في هذا المقال، نستعرض الاختلافات بين اللهجة التونسية والعربية الفصحى الحديثة (MSA)، ونوضح لماذا تؤثر هذه الاختلافات في دقة أنظمة التعرف الآلي على الكلام (ASR)، وما الذي يجب أن تتضمنه مجموعة بيانات صوتية تونسية لتحسين أداء هذه الأنظمة.
لغتان عربيتان في بلد واحد
تعيش تونس، مثل العديد من البلدان العربية، مع شكلين مختلفين من اللغة العربية. تُستخدم العربية الفصحى الحديثة في الكتابة والنشرات الإخبارية والوثائق الرسمية والخطابات الرسمية.
أما اللهجة التونسية، المعروفة باسم التونسي أو الدارجة التونسية، فهي لغة الحياة اليومية التي يستخدمها ملايين التونسيين في المنزل والعمل والمتاجر والمكالمات الهاتفية.
يطلق اللغويون على هذه الحالة مصطلح الازدواجية اللغوية (Diglossia). وبالنسبة لتقنيات الذكاء الاصطناعي الصوتي، فإن لهذه الظاهرة نتيجة واضحة: معظم النصوص العربية المتاحة، وجزء كبير من التسجيلات المستخدمة لتدريب نماذج الذكاء الاصطناعي، مكتوب أو مسجل باللغة العربية الفصحى.
لكن عندما يتصل أحد العملاء ببنك أو شركة اتصالات أو شركة تأمين في تونس، فإنه يتحدث غالباً باللهجة التونسية وليس بالعربية الفصحى.
خمسة اختلافات تجعل التعرف على الكلام أكثر صعوبة
1. المفردات والكلمات
تختلف العديد من الكلمات المستخدمة يومياً في اللهجة التونسية عن نظيراتها في العربية الفصحى، وقد لا يكون هناك تشابه واضح بينها.
- كلمة «كثيراً» تُقال في تونس برشا (Barsha) بدلاً من كثيراً.
- كلمة «الآن» تُقال توّا (Tawwa) بدلاً من الآن.
- كلمة «ماذا» تُقال شنوة (Chnouwa) بدلاً من ماذا.
إذا لم يسبق لنموذج الذكاء الاصطناعي أن تعرّف على هذه الكلمات ضمن بيانات التدريب، فسيجد صعوبة في كتابتها بشكل صحيح، حتى لو كانت قدراته على تحليل الأصوات متقدمة.
2. القواعد اللغوية
تتميز اللهجة التونسية بقواعد لغوية خاصة تنتمي إلى اللهجات المغاربية. فعلى سبيل المثال، يُستخدم الحرف «ن» في بداية الفعل للتعبير عن المتكلم المفرد.
مثلاً، كلمة نمشي (Nemchi) تعني «أنا أذهب»، بينما تُستخدم كلمة أذهب في العربية الفصحى.
كما تختلف طريقة النفي في اللهجة التونسية، حيث تُستخدم غالباً بنية تحيط بالفعل من بدايته ونهايته.
مثال: ما نحبّش (Ma Nhebbech) وتعني «لا أريد».
قد تربك هذه التراكيب نماذج الذكاء الاصطناعي التي تم تدريبها أساساً على القواعد والصيغ اللغوية للعربية الفصحى، لأنها لا تتعرف دائماً على الخصائص النحوية الخاصة باللهجة التونسية.
3. النطق وطريقة الكلام
في اللهجة التونسية، غالباً ما يتم حذف الحركات القصيرة أثناء النطق، مما يؤدي إلى ظهور تجمعات من الحروف الساكنة تختلف عن الأنماط الصوتية المعتادة في العربية الفصحى.
كما تُنطق الكلمات بسرعة أكبر، وقد يتم اختصار بعضها أثناء المحادثات اليومية. وتضاف إلى ذلك الاختلافات الإقليمية، إذ لا يتحدث سكان العاصمة تونس بالطريقة نفسها التي يتحدث بها سكان الساحل أو الجنوب التونسي.
تمثل هذه الاختلافات تحدياً حقيقياً لأنظمة التعرف الآلي على الكلام (ASR)، التي يجب أن تكون قادرة على التعرف على الكلمة نفسها رغم اختلاف طريقة نطقها من منطقة إلى أخرى.
4. المزج بين العربية والفرنسية (Code-Switching)
ينتقل التونسيون بشكل متكرر بين العربية والفرنسية أثناء الحديث، وأحياناً داخل الجملة الواحدة أو حتى داخل التعبير نفسه. وتُعرف هذه الظاهرة في علم اللغة باسم التناوب اللغوي (Code-Switching).
مثال:
“Ena mouch disponible lyoum, nkallmek ba3d la réunion.”
الترجمة: لست متاحاً اليوم، سأتصل بك بعد الاجتماع.
قد يواجه نموذج ذكاء اصطناعي تم تدريبه على لغة واحدة فقط صعوبة في التعامل مع هذه الجمل، حيث يمكن أن يحذف الكلمات الفرنسية أو يحاول كتابتها باستخدام الحروف العربية بطريقة غير صحيحة.
لهذا السبب، تحتاج أنظمة التعرف الصوتي إلى بيانات تدريب تعكس الاستخدام الحقيقي للغتين داخل المحادثات اليومية في تونس.
سنتناول هذه الظاهرة بمزيد من التفصيل في مقال قادم حول التناوب بين الفرنسية والعربية في شمال أفريقيا.
5. غياب نظام موحد للكتابة
لا تمتلك اللهجة التونسية نظاماً رسمياً موحداً للكتابة. فقد تُكتب الكلمة نفسها بعدة طرق باستخدام الحروف العربية، أو باستخدام الحروف اللاتينية والأرقام.
تُعرف الطريقة الثانية باسم العربيزي (Arabizi). على سبيل المثال، يمكن كتابة كلمة «عسلامة» باستخدام الحروف اللاتينية والأرقام بالشكل التالي: 3aslema.
في غياب قواعد واضحة وموحدة للنسخ الصوتي والكتابة، تصبح بيانات التدريب غير متناسقة، مما يؤدي إلى ارتفاع معدلات الأخطاء ويجعل تقييم أداء أنظمة التعرف على الكلام أكثر صعوبة.
ماذا تكشف الأرقام؟
يمكن قياس الفجوة في أداء أنظمة التعرف على الكلام بين اللهجات العربية المختلفة والعربية الفصحى. ففي المعيار المرجعي المنشور من شركة Cohere لنموذجها Transcribe، بلغ معدل خطأ الكلمات (Word Error Rate أو WER) في اللغة العربية لشمال أفريقيا 36.9%.
وهذا يعني أن حوالي كلمة واحدة من كل ثلاث كلمات تم التعرف عليها بشكل غير صحيح ضمن ظروف الاختبار المذكورة.
كما بدأت الشركات الكبرى في مجال الذكاء الاصطناعي تولي اهتماماً أكبر للهجات المغاربية. ففي سبتمبر 2026، أعلنت شركة Mistral AI والمغرب عن نموذج للتعرف على الكلام مخصص للهجة المغربية الدارجة.
يتزايد الطلب على البيانات الصوتية عالية الجودة الخاصة بلهجات شمال أفريقيا. ومع ذلك، لا تزال اللهجة التونسية تعاني من نقص التمثيل في مجموعات البيانات المتاحة لتدريب نماذج الذكاء الاصطناعي.
ما الذي تحتاجه مجموعة بيانات صوتية تونسية؟
إن إضافة المزيد من البيانات باللغة العربية بشكل عام لا تكفي لحل مشكلة التعرف على الكلام باللهجة التونسية. بل يجب أن تتضمن مجموعة بيانات ASR تونسية عالية الجودة العناصر التالية:
- متحدثون أصليون من مناطق مختلفة: يجب جمع التسجيلات من متحدثين أصليين في تونس الكبرى والساحل وصفاقس والشمال الغربي والجنوب، مع تحقيق توازن في الفئات العمرية والجنس.
- محادثات طبيعية وعفوية: يجب ألا تقتصر التسجيلات على قراءة الجمل المكتوبة، بل ينبغي أن تشمل محادثات حقيقية ومكالمات خدمة العملاء والإجابات القصيرة والترددات أثناء الكلام.
- المزج الحقيقي بين الفرنسية والعربية: يجب نسخ المقاطع الفرنسية بشكل صحيح وتحديدها ضمن البيانات، بدلاً من حذفها من التسجيلات.
- قواعد موحدة للنسخ الصوتي: ينبغي إعدادها من قبل مختصين في علم اللغة وتطبيقها من قبل ناسخين أصليين مدربين، مع إخضاع البيانات لعدة مراحل من مراقبة الجودة.
- بيانات وصفية دقيقة (Metadata): يجب أن تتضمن المنطقة الجغرافية للمتحدث، والفئة العمرية، والجنس، وظروف التسجيل، ومجال المحادثة.
- موافقة موثقة من المشاركين: يجب أن يوقّع كل مشارك على اتفاقية موافقة تسمح باستخدام تسجيلاته في تدريب أنظمة الذكاء الاصطناعي، مع احترام متطلبات حماية البيانات الشخصية، بما في ذلك اللائحة العامة لحماية البيانات الأوروبية (GDPR) عند انطباقها.
كيف تساهم Arabic AI Voice في تطوير هذه التقنية؟
تعمل Arabic AI Voice على جمع البيانات الصوتية باللغة العربية ولهجاتها المختلفة ونسخها وإضافة التعليقات والبيانات الوصفية إليها، بهدف استخدامها في تطبيقات الذكاء الاصطناعي، مع التركيز في البداية على منطقة المغرب العربي.
نقوم بتسجيل الأصوات داخل الاستوديو الخاص بنا في تونس، بالإضافة إلى التسجيلات الميدانية، بمشاركة متحدثين أصليين وافقوا على استخدام تسجيلاتهم.
كما يشرف مختصون لغويون من الناطقين الأصليين باللغة على عمليات النسخ والتعليق الصوتي، وفقاً لقواعد ومعايير خاصة بكل لهجة.
يمكنكم الاطلاع على المواصفات التقنية لمعرفة المزيد حول صيغ الملفات والبيانات الوصفية وطرق تسليم البيانات، بالإضافة إلى قواعد ومعايير النسخ الصوتي.
نعمل حالياً على إعداد مجموعة بيانات صوتية متخصصة في اللهجة التونسية. وبالنسبة للشركات التي لديها احتياجات خاصة، نوصي بالبدء بمشروع تجريبي لتقييم جودة البيانات ومدى توافقها مع أهداف نموذج الذكاء الاصطناعي.
هل تعملون على تطوير حلول ذكاء اصطناعي صوتية موجهة للمستخدمين في تونس؟
تواصلوا مع فريقنا لمناقشة مشروع تجريبي أو طلب عينة من البيانات الصوتية.
الأسئلة الشائعة
هل اللهجة التونسية هي نفسها اللغة العربية الفصحى؟
لا. على الرغم من أن التونسيين يفهمون العربية الفصحى بشكل عام، فإن اللهجة التونسية تختلف عنها في المفردات والقواعد اللغوية وطريقة النطق. كما تتضمن العديد من الكلمات والتعبيرات المأخوذة من اللغة الفرنسية.
هل يستطيع نموذج التعرف على الكلام المدرب باللغة العربية الفصحى فهم اللهجة التونسية؟
بشكل جزئي فقط. فقد تواجه النماذج التي تم تدريبها أساساً على العربية الفصحى صعوبات كبيرة عند التعامل مع اللهجات المغاربية. وتظل معدلات الخطأ مرتفعة ما لم يتم تدريب هذه النماذج أو تحسينها باستخدام تسجيلات صوتية أصلية تمثل اللهجة التونسية بشكل واقعي.
ما حجم البيانات الصوتية التونسية اللازم لتدريب نموذج ذكاء اصطناعي؟
تعتمد كمية البيانات المطلوبة على طبيعة الاستخدام وأهداف المشروع. فتعديل نموذج متعدد اللغات موجود مسبقاً (Fine-tuning) ليتناسب مع مجال معين يحتاج عادةً إلى بيانات أقل مقارنة بتدريب نموذج جديد بالكامل من الصفر.
لذلك، يُعد إطلاق مشروع تجريبي صغير أفضل طريقة لقياس التحسن في الأداء قبل الانتقال إلى جمع كميات أكبر من البيانات.
هل يتم جمع البيانات الصوتية بموافقة المشاركين؟
نعم. يوقّع كل مشارك على اتفاقية موافقة قبل بدء التسجيل. وبعد ذلك، تتم معالجة البيانات وفقاً لمتطلبات حماية البيانات الشخصية المعمول بها، بما في ذلك اللائحة العامة لحماية البيانات الأوروبية (GDPR) عندما تكون واجبة التطبيق.