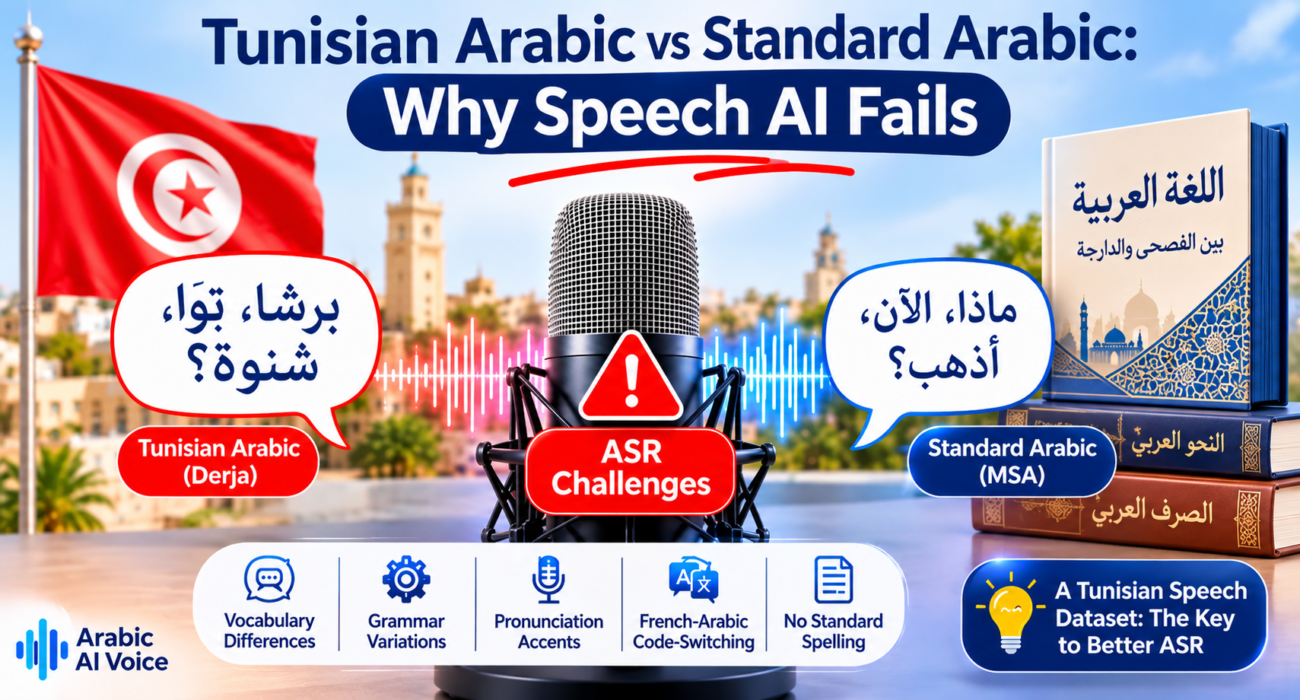
Dans cet article, nous expliquons les différences entre l’arabe tunisien et l’arabe standard moderne (MSA), pourquoi ces particularités compliquent la reconnaissance automatique de la parole (ASR) et quelles données vocales sont nécessaires pour améliorer les performances des modèles d’IA.
Deux formes d’arabe dans un même pays
La Tunisie, comme de nombreux autres pays du monde arabe, vit avec deux formes d’arabe. L’arabe standard moderne est principalement utilisé dans les textes écrits, les journaux télévisés, les documents officiels et les discours formels.
L’arabe tunisien, également appelé Tounsi ou Derja, est quant à lui la langue du quotidien. Il est parlé par environ 12 millions de personnes à la maison, au travail, dans les commerces et lors des conversations téléphoniques.
Les linguistes désignent cette situation par le terme de diglossie. Pour les technologies de reconnaissance vocale, les conséquences sont importantes : la majorité des textes arabes disponibles et une grande partie des enregistrements utilisés pour entraîner les modèles sont en arabe standard.
Pourtant, lorsqu’un client appelle une banque, un opérateur téléphonique ou une compagnie d’assurance en Tunisie, il s’exprime généralement en dialecte tunisien.
Cinq différences qui compliquent la reconnaissance vocale
1. Le vocabulaire
De nombreux mots utilisés quotidiennement en tunisien n’ont que peu de ressemblances avec leurs équivalents en arabe standard.
- « Beaucoup » se dit برشا (barsha) en tunisien, au lieu de كثيرًا.
- « Maintenant » se dit توّا (tawwa), au lieu de الآن.
- « Quoi » se dit شنوة (chnouwa), au lieu de ماذا.
Un modèle qui n’a jamais rencontré ces expressions dans ses données d’entraînement aura du mal à les transcrire correctement, même si ses capacités de modélisation acoustique sont performantes.
2. La grammaire
L’arabe tunisien possède des structures grammaticales propres aux dialectes maghrébins. À la première personne du singulier, le verbe utilise notamment le préfixe « n- ».
Par exemple, نمشي (nemchi) signifie « je vais », alors qu’en arabe standard, on utilise أذهب.
La négation présente également une construction particulière : elle encadre généralement le verbe.
Par exemple, ما نحبّش (ma nhebbech) signifie « je ne veux pas ».
Ces structures peuvent perturber les modèles entraînés principalement sur des formes grammaticales de l’arabe standard, car ils ne reconnaissent pas toujours les constructions propres au dialecte tunisien.
3. La prononciation
En arabe tunisien, les voyelles courtes sont souvent supprimées à l’oral. Cette particularité crée des groupes de consonnes qui diffèrent des structures phonétiques habituelles de l’arabe standard.
Les mots sont également prononcés plus rapidement et peuvent être raccourcis. À cela s’ajoutent les variations régionales : la manière de parler dans la capitale, sur la côte du Sahel ou dans le sud tunisien n’est pas exactement la même.
Pour un système ASR, ces différences représentent un véritable défi. Il doit reconnaître plusieurs façons de prononcer les mêmes mots et expressions, tout en conservant une transcription cohérente.
4. L’alternance entre le français et l’arabe (Code-Switching)
Les Tunisiens passent fréquemment de l’arabe au français au sein d’une même phrase, et parfois même à l’intérieur d’une même expression. Ce phénomène linguistique est appelé Code-Switching.
Exemple :
« Ena mouch disponible lyoum, nkallmek ba3d la réunion. »
Traduction : « Je ne suis pas disponible aujourd’hui, je t’appellerai après la réunion. »
Un modèle entraîné sur une seule langue à la fois risque de supprimer les mots français ou de les retranscrire incorrectement en caractères arabes.
Cette alternance linguistique nécessite des données d’entraînement spécifiques, capables de représenter fidèlement les conversations réelles des locuteurs tunisiens.
Nous approfondirons ce sujet dans un prochain article consacré au code-switching entre le français et l’arabe en Afrique du Nord.
5. L’absence d’orthographe standardisée
L’arabe tunisien ne dispose pas d’un système officiel d’écriture standardisé. Un même mot peut être écrit de différentes manières en caractères arabes ou en lettres latines accompagnées de chiffres.
Cette dernière méthode est appelée Arabizi. Par exemple, le mot « عسلامة » (bonjour) peut être écrit 3aslema.
En l’absence de conventions de transcription précises, les données utilisées pour entraîner les modèles deviennent incohérentes. Cela augmente les erreurs de reconnaissance et complique l’évaluation des performances des systèmes ASR.
Ce que révèlent les chiffres
L’écart de performance entre les différents dialectes arabes et l’arabe standard peut être mesuré. Dans le benchmark publié par Cohere pour son modèle Transcribe, le taux d’erreur de mots (Word Error Rate ou WER) sur l’arabe nord-africain atteignait 36,9 %. Cela signifie qu’environ un mot sur trois était incorrectement reconnu dans les conditions de ce benchmark.
Les grands acteurs de l’intelligence artificielle commencent également à s’intéresser davantage aux dialectes maghrébins. En septembre 2026, Mistral AI et le Maroc ont notamment annoncé un modèle de reconnaissance vocale dédié à la Darija marocaine.
La demande en données vocales de qualité pour les dialectes nord-africains progresse. Pourtant, l’arabe tunisien reste encore insuffisamment représenté dans les jeux de données disponibles pour l’entraînement des modèles d’intelligence artificielle.
De quelles données vocales l’arabe tunisien a-t-il besoin ?
Ajouter simplement davantage de données en arabe ne suffit pas à résoudre les problèmes de reconnaissance vocale. Un jeu de données ASR tunisien de qualité doit intégrer plusieurs éléments essentiels :
- Des locuteurs natifs issus de différentes régions : Grand Tunis, Sahel, Sfax, Nord-Ouest et Sud, avec une représentation équilibrée des âges et des genres.
- Des conversations spontanées : ne pas se limiter à des phrases lues. Les enregistrements doivent inclure des conversations naturelles, des appels au service client, des réponses courtes et des hésitations.
- Une alternance réelle entre le français et l’arabe : les passages en français doivent être correctement transcrits et identifiés, plutôt que supprimés des enregistrements.
- Des règles de transcription cohérentes : élaborées par un linguiste et appliquées par des transcripteurs natifs formés, avec plusieurs niveaux de contrôle qualité.
- Des métadonnées détaillées : région du locuteur, tranche d’âge, genre, conditions d’enregistrement et domaine de conversation.
- Un consentement documenté : chaque participant doit signer un accord autorisant l’utilisation de ses enregistrements pour l’entraînement de systèmes d’IA, dans le respect du RGPD.
Comment Arabic AI Voice contribue à cette évolution
Arabic AI Voice collecte, transcrit et annote des données vocales en arabe et dans ses dialectes pour les applications d’intelligence artificielle, en commençant par le Maghreb.
Nous réalisons des enregistrements dans notre studio à Tunis ainsi que sur le terrain, auprès de locuteurs natifs ayant donné leur consentement. La transcription et l’annotation sont supervisées par des linguistes natifs, selon des conventions adaptées aux particularités de chaque dialecte.
Vous pouvez consulter nos spécifications techniques pour découvrir les formats, les métadonnées et les modalités de livraison, ainsi que nos conventions de transcription.
Un jeu de données vocales dédié à l’arabe tunisien est actuellement en préparation. Pour les entreprises ayant des besoins spécifiques, nous recommandons de commencer par un projet pilote afin d’évaluer la qualité des données et leur adéquation avec les objectifs du modèle.
Vous développez une solution d’intelligence artificielle vocale destinée aux utilisateurs tunisiens ?
Contactez notre équipe pour discuter d’un projet pilote ou demander un échantillon de données.
Foire aux questions (FAQ)
L’arabe tunisien est-il identique à l’arabe standard ?
Non. Même si les Tunisiens comprennent généralement l’arabe standard moderne, l’arabe tunisien présente des différences importantes en matière de vocabulaire, de grammaire et de prononciation. Il intègre également de nombreux mots et expressions issus du français.
Un modèle de reconnaissance vocale entraîné sur l’arabe standard peut-il comprendre le tunisien ?
Partiellement. Les modèles entraînés principalement sur l’arabe standard peuvent rencontrer des difficultés avec les dialectes nord-africains. Les taux d’erreur restent élevés lorsque les modèles ne sont pas entraînés ou ajustés à partir d’enregistrements natifs représentatifs de ces dialectes.
Quelle quantité de données vocales tunisiennes faut-il pour entraîner un modèle ?
La quantité nécessaire dépend du cas d’utilisation et des objectifs du projet. L’ajustement (fine-tuning) d’un modèle multilingue existant sur un domaine spécifique nécessite généralement moins de données qu’un entraînement complet depuis zéro.
La meilleure approche consiste à lancer un projet pilote pour mesurer les gains de performance avant d’augmenter le volume de collecte.
Les données vocales sont-elles collectées avec le consentement des participants ?
Oui. Chaque participant signe un accord de consentement avant l’enregistrement. Les données sont ensuite traitées conformément aux exigences applicables en matière de protection des données personnelles, notamment le RGPD lorsque celui-ci s’applique.