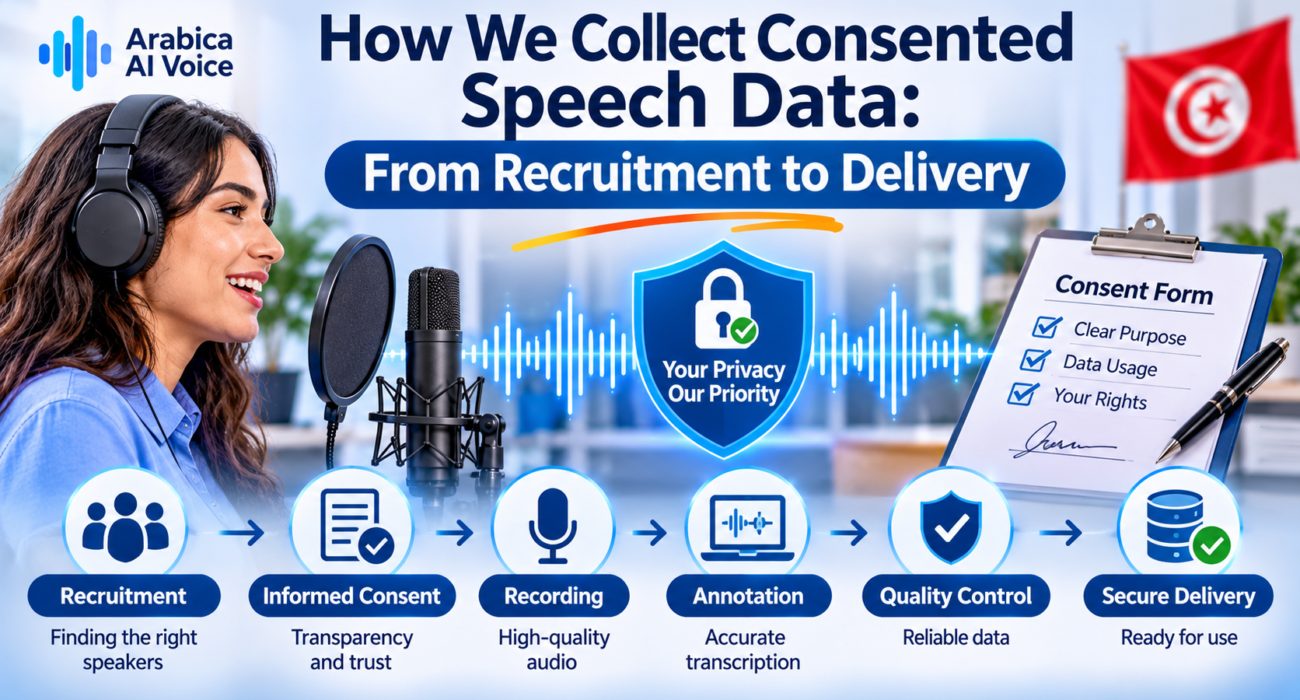
Les systèmes de reconnaissance vocale de haute qualité ne reposent pas uniquement sur des algorithmes. Ils commencent par de véritables voix humaines.
Derrière chaque modèle fiable de reconnaissance automatique de la parole (ASR) se trouve une collection d’enregistrements audio permettant à l’intelligence artificielle de comprendre différents accents, langues, prononciations et habitudes de communication.
Cependant, la collecte de données vocales ne consiste pas simplement à enregistrer des personnes en train de parler. Elle nécessite un processus structuré qui respecte les droits des participants, protège leurs informations personnelles et garantit que chaque enregistrement répond à des normes de qualité clairement définies.
Chez Arabic AI Voice, le consentement et la qualité des données sont des éléments essentiels dans le développement de projets de collecte de données vocales.
Du recrutement de locuteurs natifs à la validation des enregistrements et à la livraison de jeux de données structurés, chaque étape contribue à la création de solutions fiables en intelligence artificielle vocale.
Dans cet article, nous expliquons comment fonctionne un processus responsable de collecte de données vocales, depuis le premier contact avec un participant jusqu’à la livraison finale du dataset.
1. Pourquoi le consentement est-il essentiel dans la collecte de données vocales ?
Les enregistrements vocaux contiennent bien plus que des mots prononcés. Ils peuvent révéler des informations personnelles, des habitudes de communication, des accents et d’autres caractéristiques permettant d’identifier un locuteur.
Le consentement éclairé constitue donc une exigence fondamentale pour une collecte responsable de données vocales.
Avant le début de l’enregistrement, les participants doivent comprendre précisément ce à quoi ils acceptent de prendre part.
Une procédure de consentement transparente doit expliquer :
- Qui collecte les enregistrements.
- Pourquoi les données vocales sont collectées.
- Comment les enregistrements seront utilisés.
- Si les données serviront à entraîner ou à évaluer des modèles d’intelligence artificielle.
- Qui pourra accéder aux enregistrements.
- Combien de temps les données seront conservées.
- Si les enregistrements seront partagés avec des tiers.
- Comment les participants peuvent exercer leurs droits en matière de protection des données.
Le consentement doit être libre, éclairé, spécifique et documenté. Les participants doivent également pouvoir poser leurs questions avant de donner leur accord.
Il est important de souligner que le consentement à participer à un projet d’enregistrement ne constitue pas une autorisation illimitée permettant d’utiliser la voix d’une personne pour n’importe quelle utilisation future.
2. Recrutement des participants : trouver les bons locuteurs
La première étape opérationnelle consiste à recruter des participants correspondant aux exigences linguistiques et démographiques du projet.
Pour les jeux de données vocaux en arabe, le recrutement est particulièrement important, car l’arabe est parlé sous de nombreuses variantes régionales, chacune possédant son propre vocabulaire, sa prononciation et ses structures grammaticales.
Par exemple, un dataset consacré à l’arabe tunisien nécessite des locuteurs qui communiquent naturellement en dialecte tunisien, et pas uniquement en arabe standard moderne.
Définir les critères de recrutement
Avant de lancer le recrutement, l’équipe du projet définit le profil des participants recherchés.
Selon les besoins du projet, ces critères peuvent inclure :
- Des locuteurs natifs ou maîtrisant parfaitement la langue.
- Des dialectes arabes et des accents régionaux spécifiques.
- Des tranches d’âge, lorsque ces informations sont pertinentes et collectées légalement.
- Une représentation des genres, lorsque cela est pertinent pour les objectifs de recherche.
- Différents niveaux d’éducation ou parcours professionnels.
- Des variations linguistiques entre les zones urbaines et rurales.
- Des locuteurs bilingues français-arabe ou anglais-arabe.
Ces critères permettent de constituer un dataset représentatif plutôt qu’une simple collection d’enregistrements provenant d’un groupe restreint de locuteurs.
Recruter des participants en Afrique du Nord
Pour les projets multilingues consacrés à l’arabe, le recrutement peut couvrir plusieurs pays et régions.
Voici quelques exemples :
- Tunisie : arabe tunisien (Tounsi).
- Algérie : arabe algérien (Darja).
- Maroc : arabe marocain (Darija).
- Libye : arabe libyen.
Le recrutement peut s’effectuer à travers des réseaux communautaires, des partenaires professionnels spécialisés dans le recrutement, des communautés linguistiques et des plateformes dédiées aux participants.
L’objectif est d’obtenir des enregistrements authentiques auprès de personnes qui utilisent naturellement la langue ou le dialecte ciblé dans leur vie quotidienne.
3. Consentement éclairé : expliquer le processus d’enregistrement
Une fois les participants potentiels identifiés, l’étape suivante consiste à obtenir leur consentement éclairé.
Cette étape doit impérativement avoir lieu avant le début de tout enregistrement couvert par l’accord de consentement.
Les participants doivent recevoir des informations claires dans une langue qu’ils comprennent.
Que doit contenir un formulaire de consentement ?
Un formulaire de consentement bien conçu couvre généralement les éléments suivants :
- Objectif du projet : pourquoi les enregistrements sont collectés et quels résultats le projet cherche à atteindre.
- Activités d’enregistrement : les types de prises de parole demandées aux participants, notamment les exercices de lecture, les conversations spontanées ou les dialogues scénarisés.
- Utilisation des données : préciser si les enregistrements seront utilisés pour l’entraînement ASR, la synthèse vocale, la recherche linguistique, l’évaluation ou d’autres finalités définies.
- Confidentialité et sécurité : expliquer comment les fichiers audio et les informations associées seront stockés, protégés et accessibles.
- Partage des données : indiquer si les enregistrements pourront être partagés avec des clients, des partenaires de recherche ou d’autres organisations autorisées.
- Durée de conservation : préciser combien de temps les enregistrements et les informations associées seront conservés.
- Droits des participants : expliquer comment retirer son consentement ou exercer les droits applicables en matière de protection des données, conformément au cadre juridique et contractuel concerné.
Une procédure de consentement claire renforce la confiance et contribue à garantir une collecte responsable des données vocales.
4. Enregistrement des données vocales : capturer des voix humaines naturelles
Après le recrutement et l’obtention du consentement, les participants peuvent passer à l’étape de l’enregistrement.
L’objectif est de collecter des fichiers audio clairs et représentatifs, reflétant la manière dont les personnes parlent réellement.
Cependant, les conditions d’enregistrement peuvent avoir une influence importante sur l’utilité du dataset.
Choisir le bon environnement d’enregistrement
Selon les exigences du projet, les enregistrements peuvent être réalisés dans différents environnements :
- Des studios d’enregistrement professionnels.
- Des bureaux calmes.
- Des environnements domestiques contrôlés.
- Des dispositifs d’enregistrement mobiles.
L’environnement doit limiter les bruits de fond indésirables, l’écho et les interférences liées au microphone.
Équipements d’enregistrement et exigences techniques
Les spécifications audio doivent être définies avant le début des enregistrements.
Les principaux éléments à prendre en compte comprennent :
- La fréquence d’échantillonnage.
- La profondeur de bits audio.
- L’enregistrement mono ou stéréo.
- Les formats audio pris en charge, tels que WAV.
- Le positionnement du microphone.
- La durée des enregistrements.
- Les seuils de bruit de fond.
- La saturation et la distorsion audio.
Les exigences techniques exactes dépendent de l’application d’intelligence artificielle visée.
Par exemple, un dataset destiné à entraîner un système de reconnaissance vocale de haute qualité peut nécessiter des conditions d’enregistrement différentes d’un dataset conçu pour évaluer la reconnaissance vocale dans des environnements bruyants.
Lecture de scripts et conversations spontanées
La collecte de données vocales peut s’appuyer sur différentes méthodes d’enregistrement.
Enregistrements avec scripts :
Les participants lisent des phrases, des paragraphes ou des consignes prédéfinis. Cette approche permet de contrôler le vocabulaire, la couverture phonétique et les structures linguistiques.
Discours spontané :
Les participants parlent naturellement de sujets de la vie quotidienne. Cette méthode permet de capturer les expressions conversationnelles, les hésitations, le vocabulaire informel et la prononciation naturelle.
Enregistrements conversationnels :
Deux personnes ou plus participent à un dialogue structuré. Cela permet de capturer les changements de tour de parole, les interruptions et les variations de styles de communication.
Pour les projets consacrés à l’arabe nord-africain, la combinaison de ces méthodes permet d’obtenir une représentation plus complète des échanges quotidiens.
5. Couverture des dialectes et diversité linguistique
L’un des principaux défis de la collecte de données vocales en arabe est la diversité linguistique.
L’arabe standard moderne joue un rôle important dans la communication formelle, l’éducation et les médias. Cependant, des millions de locuteurs arabophones communiquent principalement dans des dialectes régionaux.
Un dataset exclusivement consacré à l’arabe formel risque donc de ne pas représenter correctement les conversations de tous les jours.
Collecter les différentes variantes régionales de l’arabe
Un dataset complet consacré à la parole en Afrique du Nord peut inclure :
- L’arabe tunisien.
- L’arabe algérien.
- L’arabe marocain.
- L’arabe libyen.
Chaque dialecte doit être considéré comme une variante linguistique distincte, avec son propre vocabulaire, ses habitudes de prononciation et ses caractéristiques grammaticales.
Capturer le mélange des langues (code-switching)
La communication multilingue constitue un autre élément important.
En Tunisie, en Algérie et au Maroc, les locuteurs alternent fréquemment entre l’arabe et le français au cours d’une même conversation.
Par exemple :
« El réunion mta3 ghodwa, nbadlouha wala nkhaliwha ? »
Cette phrase combine l’arabe tunisien et du vocabulaire français.
La collecte de ce type d’expressions est particulièrement utile pour les systèmes de reconnaissance vocale destinés aux conversations multilingues de la vie réelle.
Un dataset représentatif doit donc intégrer les alternances naturelles entre les langues lorsque celles-ci font partie du périmètre linguistique du projet.
6. Transcription et annotation des données vocales
Une fois les enregistrements collectés, l’étape suivante consiste à effectuer leur transcription et leur annotation.
Ce processus transforme les fichiers audio en informations structurées qui peuvent être utilisées pour entraîner, valider et évaluer des modèles d’intelligence artificielle.
Transcription audio
La transcription consiste à convertir les paroles enregistrées en texte écrit.
Pour l’arabe dialectal, il est nécessaire de définir des règles de transcription claires, car une même expression peut être écrite de plusieurs façons.
Par exemple, l’arabe tunisien peut être représenté en utilisant :
- L’alphabet arabe.
- La translittération latine.
- L’Arabizi.
Le projet doit établir une convention d’écriture cohérente avant le début de l’annotation.
Identification des locuteurs
Dans les enregistrements comportant plusieurs personnes, chaque locuteur doit recevoir un identifiant cohérent.
Ce processus, appelé diarisation des locuteurs, permet d’identifier qui parle et à quel moment de l’enregistrement.
Alignement temporel
L’alignement temporel associe les mots ou les phrases prononcés à leurs positions correspondantes dans l’enregistrement audio.
Selon les exigences du projet, les annotations peuvent inclure :
- Des horodatages au niveau des mots.
- Des horodatages au niveau des phrases.
- Des identifiants de locuteurs.
- L’identification de la langue.
- L’identification du dialecte.
- Des indicateurs de bruit de fond.
- Les événements non verbaux.
Ces annotations rendent les datasets plus utiles pour différentes applications d’intelligence artificielle vocale.
7. Contrôle qualité : garantir la fiabilité des données vocales
La collecte des enregistrements ne représente qu’une partie du processus.
Avant de pouvoir être livré, un dataset doit passer par une étape de contrôle qualité.
Son objectif est d’identifier les enregistrements qui ne respectent pas les exigences techniques, linguistiques ou d’annotation définies pour le projet.
Vérification de la qualité audio
Les fichiers audio peuvent être contrôlés afin de détecter :
- Un bruit de fond excessif.
- Une voix déformée ou saturée.
- Un volume d’enregistrement trop faible.
- Des segments audio manquants.
- Des formats de fichiers incorrects.
- Des périodes de silence inattendues.
- Des interruptions pendant l’enregistrement.
Vérification de la qualité des transcriptions
Les transcriptions doivent également être vérifiées afin de détecter :
- Des mots manquants.
- Un vocabulaire incorrect.
- Des incohérences orthographiques.
- Des identifiants de locuteurs incorrects.
- Des erreurs d’horodatage.
- Des expressions dialectales mal identifiées.
Validation humaine
Les outils automatisés peuvent aider à détecter les problèmes techniques, mais la vérification humaine reste importante pour les discours dialectaux.
Les locuteurs natifs ou les personnes maîtrisant parfaitement le dialecte peuvent identifier des erreurs linguistiques que les systèmes automatisés risquent de ne pas détecter.
Un processus d’assurance qualité peut comprendre une première annotation, une vérification indépendante, la résolution des divergences et une validation finale.
8. Confidentialité des données, sécurité et gestion des accès
La collecte de données vocales implique des responsabilités qui se poursuivent bien après la session d’enregistrement.
Les fichiers audio et leurs métadonnées associées doivent être traités conformément aux exigences applicables en matière de confidentialité et de protection des données.
Un processus responsable doit inclure :
- Stockage sécurisé : protéger les enregistrements contre les accès non autorisés, la perte ou la modification.
- Contrôle des accès : limiter l’accès aux membres autorisés du projet et aux partenaires approuvés.
- Minimisation des données : collecter uniquement les informations personnelles nécessaires au projet.
- Pseudonymisation : utiliser des identifiants de participants plutôt que des informations directement identifiantes lorsque cela est possible.
- Gestion de la conservation : définir la durée de conservation des enregistrements et des informations associées.
- Procédures de suppression : mettre en place des procédures permettant de traiter les demandes valides de suppression ou de retrait conformément aux obligations applicables.
Les enregistrements vocaux ne doivent pas être automatiquement considérés comme anonymes simplement parce que le nom du participant a été supprimé. La voix elle-même peut permettre son identification.
Pour les projets impliquant des participants ou des organisations européennes, les exigences du RGPD peuvent s’appliquer. D’autres législations locales relatives à la protection des données peuvent également être pertinentes selon le lieu de recrutement des participants et le lieu de traitement des données.
9. Préparation du dataset et livraison finale
Après la transcription, l’annotation et le contrôle qualité, le dataset est préparé pour sa livraison.
La structure finale dépend des exigences techniques du client et de l’application à laquelle les données sont destinées.
Un package de données vocales peut comprendre :
Fichiers audio
Les enregistrements originaux sont organisés conformément à la structure de dossiers et aux conventions de nommage définies pour le projet.
Les formats courants incluent WAV et d’autres formats audio convenus avec le client.
Fichiers de transcription
Des fichiers texte contenant le contenu correspondant aux paroles enregistrées.
Les métadonnées structurées peuvent inclure :
- Les identifiants des locuteurs.
- Les étiquettes de langue.
- Les étiquettes de dialecte.
- Les horodatages des mots ou des phrases.
- Les informations relatives aux enregistrements.
- Les résultats du contrôle qualité.
Documentation du dataset
La documentation permet aux clients de comprendre le dataset et de l’utiliser correctement.
Elle peut inclure :
- La description du dataset.
- La méthodologie d’enregistrement.
- Les critères de recrutement des participants.
- Les informations relatives au consentement et aux utilisations autorisées.
- Les spécifications techniques audio.
- Les règles de transcription.
- Les conventions d’annotation.
- La méthodologie d’assurance qualité.
- Les limites connues du dataset.
Transfert sécurisé
Le package final peut être livré au moyen d’une méthode de transfert sécurisé convenue avec le client.
Les autorisations d’accès, la confirmation de livraison et toute documentation applicable relative au traitement des données doivent être établies avant la remise finale.
L’objectif est de fournir un dataset organisé, documenté, validé et prêt à être intégré dans le processus de travail prévu par le client.
10. Des voix humaines à une meilleure intelligence artificielle arabe
La collecte de données vocales est un processus qui relie la communication humaine à l’intelligence artificielle.
Pour les technologies vocales arabes, la qualité de ce processus est particulièrement importante, car les dialectes régionaux, les accents et les expressions multilingues ne sont pas toujours suffisamment représentés dans les datasets traditionnels.
Un processus fiable de collecte de données vocales nécessite bien plus que du matériel d’enregistrement.
Il repose sur :
- Un recrutement des participants soigneusement planifié.
- Un consentement transparent et éclairé.
- Des conditions d’enregistrement adaptées.
- Une couverture linguistique représentative.
- Une transcription et une annotation précises.
- Un contrôle qualité cohérent.
- Des pratiques responsables en matière de confidentialité et de sécurité.
- Une livraison structurée du dataset.
Chez Arabic AI Voice, la diversité de la parole arabe constitue un élément essentiel dans le développement de technologies vocales plus représentatives.
En mettant l’accent sur le consentement, la diversité linguistique et la qualité des données, les projets de collecte vocale peuvent contribuer à créer des systèmes d’intelligence artificielle qui comprennent mieux la manière dont les personnes communiquent dans la vie réelle.