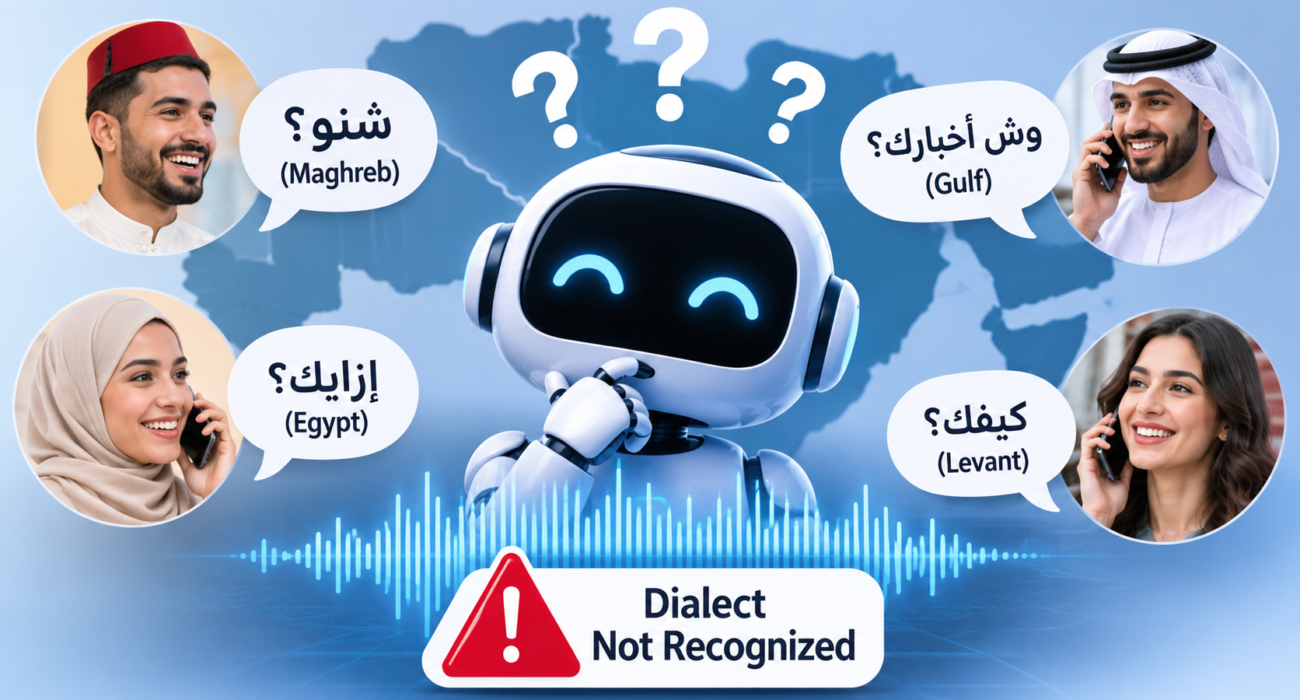
À mesure que les assistants vocaux, les applications de reconnaissance vocale, les plateformes automatisées de service client et les outils d’intelligence artificielle conversationnelle se généralisent, la compréhension des dialectes arabes devient de plus en plus importante. Développer une IA vocale arabe fiable nécessite bien plus que la simple collecte d’enregistrements en arabe. Cela exige des jeux de données vocaux représentatifs de la manière dont les gens parlent réellement.
Dans cet article, nous explorons les principaux groupes de dialectes arabes, expliquons pourquoi ils sont difficiles à reconnaître pour les systèmes d’IA et examinons comment des données audio de haute qualité et une annotation linguistique précise peuvent améliorer la reconnaissance vocale arabe.
1. L’arabe est une langue riche en dialectes
L’une des caractéristiques les plus importantes de l’arabe est la coexistence de l’arabe standard moderne (ASM) et de nombreuses variétés régionales parlées.
L’arabe standard moderne est couramment utilisé dans les écrits formels, l’éducation, les médias d’information, les communications officielles et les discours publics. Cependant, les conversations quotidiennes se déroulent généralement dans les dialectes locaux, qui peuvent être très différents de la langue formelle.
Les arabophones peuvent passer de l’arabe standard moderne à leur dialecte local selon la situation, leur interlocuteur et le sujet de la conversation. Ce phénomène est souvent appelé alternance codique (code-switching) ou variation de registre.
Pour les systèmes de reconnaissance vocale, cela signifie que la langue traitée peut varier considérablement d’un enregistrement à l’autre, voire au sein d’une même phrase.
Arabe standard moderne et arabe parlé
L’arabe standard moderne constitue une référence linguistique relativement normalisée. Les dialectes parlés, quant à eux, reflètent les identités régionales, les influences culturelles et les habitudes de communication quotidiennes.
Par exemple, une phrase en arabe formel peut contenir du vocabulaire et des structures grammaticales rarement utilisés dans les conversations informelles. Un locuteur peut également prononcer certains mots différemment ou employer une expression complètement différente selon sa région.
Cette distinction est importante, car un modèle d’IA principalement entraîné sur l’arabe formel risque de ne pas reconnaître le vocabulaire, la prononciation et les structures de phrases utilisés quotidiennement par les arabophones.
2. Les principaux groupes de dialectes arabes
Les dialectes arabes sont généralement regroupés selon leurs similitudes géographiques et linguistiques. Bien que ces classifications soient utiles, chaque groupe comprend également des variétés locales et des différences entre les villes, les régions et les communautés.
L’arabe maghrébin : dialectes marocain, algérien et tunisien
L’arabe maghrébin est parlé en Afrique du Nord, notamment au Maroc, en Algérie, en Tunisie ainsi que dans certaines régions de la Libye et de la Mauritanie.
La darija marocaine, l’arabe algérien et l’arabe tunisien partagent des caractéristiques historiques et linguistiques, mais possèdent également un vocabulaire, des particularités de prononciation et des expressions qui leur sont propres.
Ces dialectes sont influencés par plusieurs langues, notamment les langues amazighes, le français et, selon les régions, l’espagnol et d’autres langues.
Les principaux défis pour les systèmes d’IA comprennent :
- Des particularités de prononciation différentes de celles de l’arabe standard moderne.
- Un vocabulaire régional et des expressions qui peuvent être absents des jeux de données en arabe standard.
- L’utilisation fréquente de mots français ou d’autres langues étrangères dans les conversations quotidiennes.
- Des différences de prononciation entre les locuteurs de différentes villes et régions.
- Une disponibilité limitée de grands jeux de données vocales correctement annotés pour certaines variétés.
Par exemple, l’arabe tunisien intègre fréquemment des mots français dans les conversations quotidiennes. Un locuteur peut naturellement mélanger des mots arabes et français au sein d’une même phrase, ce qui crée des difficultés supplémentaires pour les systèmes de reconnaissance automatique de la parole.
L’arabe égyptien
L’arabe égyptien est l’un des dialectes arabes les plus connus, notamment grâce à l’influence du cinéma, de la télévision, de la musique et des médias numériques égyptiens.
Malgré sa forte présence dans les contenus médiatiques, l’arabe égyptien reste différent de l’arabe standard moderne en matière de prononciation, de vocabulaire et de grammaire.
Les systèmes d’IA doivent apprendre à reconnaître les expressions égyptiennes courantes, les structures grammaticales familières et les variations de prononciation entre les locuteurs. Les données d’entraînement exclusivement basées sur l’arabe formel ne permettent pas de représenter pleinement ces caractéristiques.
L’arabe levantin
L’arabe levantin est parlé dans des pays tels que le Liban, la Syrie, la Jordanie et la Palestine.
Bien que ces variétés partagent de nombreuses caractéristiques linguistiques, elles ne sont pas identiques. Les différences de vocabulaire, de prononciation et d’expressions locales peuvent influencer la manière dont les systèmes de reconnaissance vocale interprètent les conversations.
L’arabe levantin présente également des variations régionales et sociales. Un modèle performant sur une variété peut produire des transcriptions moins précises lorsqu’il est confronté à une autre.
L’arabe du Golfe
L’arabe du Golfe regroupe les variétés parlées dans des pays tels que l’Arabie saoudite, les Émirats arabes unis, le Koweït, le Qatar, Bahreïn et Oman.
Ces variétés possèdent leurs propres particularités de prononciation, leur vocabulaire et leurs expressions. Des différences existent également entre les communautés urbaines et rurales ainsi qu’entre les pays voisins.
Pour les développeurs d’IA, il est important de collecter des données vocales provenant de plusieurs régions du Golfe afin d’éviter de créer des modèles performants uniquement pour un groupe précis de locuteurs.
L’arabe soudanais et les autres variétés régionales
L’arabe soudanais et d’autres variétés régionales contribuent également à la diversité linguistique du monde arabophone.
Ces variétés peuvent contenir un vocabulaire particulier, des caractéristiques de prononciation distinctives et des influences provenant des langues locales. Leur représentation dans les jeux de données destinés aux technologies vocales peut être limitée par rapport aux variétés les plus étudiées.
L’intégration de ces variétés dans les jeux de données vocaux arabes permet d’améliorer la couverture linguistique et de rendre les systèmes d’IA plus utiles à un plus grand nombre de locuteurs.
3. Pourquoi les dialectes arabes posent-ils des problèmes à l’IA ?
La diversité des dialectes arabes ne se limite pas à des différences d’accent. Elle affecte plusieurs éléments fondamentaux de la reconnaissance automatique de la parole, notamment le vocabulaire, la prononciation, la grammaire et la modélisation linguistique.
Des mots différents pour exprimer le même sens
Les arabophones peuvent utiliser des mots complètement différents pour exprimer une même idée selon leur région.
Un modèle de reconnaissance vocale entraîné sur un dialecte peut rencontrer un vocabulaire inconnu lorsqu’il traite un autre dialecte. Si ses données d’entraînement ne contiennent pas suffisamment d’exemples de ces expressions, il risque de les remplacer par des mots plus familiers ou de produire des transcriptions incorrectes.
Ce problème devient particulièrement important lorsqu’un modèle doit servir des utilisateurs provenant de plusieurs pays arabophones.
Les différences de prononciation et d’accent
Les différences de prononciation peuvent compliquer l’identification correcte des mots par les systèmes d’IA.
Les dialectes arabes peuvent différer dans la manière dont certaines consonnes sont prononcées, dont les voyelles sont réalisées et dont les sons évoluent dans la parole enchaînée. Même au sein d’un même dialecte, les locuteurs peuvent présenter des accents, des rythmes de parole et des habitudes d’articulation différents.
Les modèles de reconnaissance vocale doivent apprendre à distinguer les différences linguistiques significatives des variations naturelles entre les locuteurs.
L’alternance entre l’arabe et d’autres langues
De nombreux arabophones mélangent naturellement l’arabe avec le français ou l’anglais, notamment dans les environnements professionnels, l’éducation, la technologie et les communications numériques quotidiennes.
Cette pratique, appelée alternance codique (code-switching), représente un défi supplémentaire pour les systèmes de reconnaissance vocale.
Par exemple, un locuteur tunisien peut utiliser un terme technique français au milieu d’une phrase en arabe, tandis qu’un locuteur d’une autre région peut intégrer des termes anglais.
Un modèle entraîné uniquement sur des enregistrements en arabe risque de ne pas reconnaître ces mots ou de les convertir incorrectement en expressions arabes ayant une prononciation similaire.
Les différences grammaticales et les structures de phrases
Les dialectes arabes peuvent différer de l’arabe standard moderne en matière de structures grammaticales, de formes verbales, de pronoms et de construction des phrases.
Ces différences influencent la manière dont les mots sont reliés et dont les phrases sont interprétées. Un modèle linguistique qui repose fortement sur la grammaire de l’arabe formel peut rencontrer des difficultés avec des expressions familières parfaitement naturelles pour les locuteurs natifs.
Des données d’entraînement limitées et déséquilibrées
L’un des principaux défis concerne la disponibilité et la répartition des jeux de données vocaux arabes.
Certains dialectes sont mieux représentés que d’autres dans les collections audio accessibles au public. Si un modèle reçoit des milliers d’heures d’enregistrements d’une seule variété, mais très peu de données provenant d’une autre, ses performances risquent de refléter ce déséquilibre.
Cela crée un problème de couverture linguistique : le modèle peut sembler précis lors des tests tout en restant peu fiable pour les locuteurs dont les dialectes sont insuffisamment représentés pendant l’entraînement.
4. Pourquoi les données d’entraînement en arabe standard moderne ne suffisent-elles pas ?
L’arabe standard moderne est essentiel pour de nombreuses applications, mais il ne peut pas représenter toute la diversité de l’arabe parlé.
Prenons l’exemple d’un système de transcription automatique utilisé par une entreprise pour traiter les appels de son service client. Les clients peuvent parler en tunisien, marocain, égyptien, levantin ou arabe du Golfe. Ils peuvent également passer d’un dialecte à l’arabe formel au cours d’une même conversation.
Si le modèle a principalement appris à partir d’enregistrements de journaux télévisés en arabe formel, il risque de rencontrer des difficultés avec :
- Les expressions informelles et le vocabulaire familier.
- Les différences régionales de prononciation et d’accent.
- Les conversations rapides et spontanées.
- Les mots étrangers intégrés dans les phrases arabes.
- Les phrases incomplètes, les répétitions et les hésitations naturelles de la parole.
Pour cette raison, le développement de l’IA vocale arabe doit inclure des données issues aussi bien de discours formels que de conversations quotidiennes. Une stratégie d’entraînement équilibrée aide les modèles à comprendre la différence entre la manière dont l’arabe s’écrit et la manière dont il est réellement parlé.
5. L’importance des jeux de données vocaux spécifiques aux dialectes arabes
Les jeux de données vocaux de haute qualité constituent l’un des fondements les plus importants d’une reconnaissance vocale arabe fiable.
Au lieu de considérer l’arabe comme une catégorie linguistique homogène, les développeurs doivent prendre en compte la diversité linguistique de leurs utilisateurs cibles lors de la collecte et de la préparation des données d’entraînement.
Représenter différents pays et différentes régions
Un jeu de données vocales arabe représentatif doit inclure des locuteurs provenant de différentes zones géographiques. Selon les besoins du projet, il peut couvrir les variétés marocaine, algérienne, tunisienne, libyenne, égyptienne, soudanaise, levantine et celles du Golfe.
L’objectif n’est pas nécessairement d’inclure tous les dialectes dans chaque projet. Il s’agit plutôt de garantir que le jeu de données reflète les utilisateurs visés et les conditions réelles dans lesquelles le système d’IA sera utilisé.
Inclure différents profils de locuteurs
La couverture des dialectes ne suffit pas. Les jeux de données vocaux doivent également tenir compte des différences entre les locuteurs.
Les dimensions importantes comprennent :
- Les différentes tranches d’âge et les styles de parole.
- La diversité des genres.
- Les origines urbaines et rurales.
- Les différents niveaux d’éducation et d’exposition linguistique.
- Les locuteurs natifs et non natifs, lorsque cela est pertinent pour le projet.
Cette diversité contribue à réduire le risque de développer des systèmes qui fonctionnent correctement uniquement pour un groupe restreint d’utilisateurs.
Enregistrer des conversations naturelles
Les enregistrements réalisés en studio dans des conditions contrôlées sont utiles pour certaines tâches d’entraînement, mais la parole dans le monde réel est souvent plus complexe.
Les enregistrements conversationnels peuvent contenir des interruptions, des bruits de fond, des chevauchements de voix, des hésitations et des expressions informelles. L’intégration d’exemples adaptés à ces conditions aide les développeurs à évaluer les performances de leurs systèmes en dehors des environnements d’enregistrement contrôlés.
6. Pourquoi une transcription et une annotation précises sont-elles importantes ?
La collecte de fichiers audio ne représente qu’une partie du développement d’un jeu de données vocales fiable. Les enregistrements doivent également être transcrits et annotés de manière cohérente.
La transcription de l’arabe nécessite des décisions précises concernant l’orthographe, la représentation des dialectes, la ponctuation, les mots en langues étrangères et les hésitations dans la parole.
Pour les projets d’IA axés sur les dialectes, les consignes d’annotation doivent définir clairement la manière dont les expressions familières sont représentées à l’écrit.
Identification des dialectes
Chaque enregistrement ou segment peut être associé à des informations permettant d’identifier le dialecte utilisé. Selon les exigences du projet, les étiquettes peuvent préciser le pays, la variété régionale ou une catégorie dialectale plus spécifique.
Ces informations aident les développeurs à organiser les jeux de données, à analyser les performances des modèles et à identifier les dialectes nécessitant des données d’entraînement supplémentaires.
Diarisation des locuteurs
La diarisation des locuteurs consiste à identifier qui parle et à quel moment. Elle est particulièrement utile pour les enregistrements contenant plusieurs participants, tels que les interviews, les réunions et les conversations du service client.
L’association d’une transcription précise à des étiquettes de locuteurs fournit des données d’entraînement et d’évaluation plus riches pour les technologies vocales.
Des consignes de transcription cohérentes
Différents annotateurs peuvent écrire une même expression dialectale de plusieurs manières, notamment lorsqu’il n’existe aucun système d’orthographe normalisé pour cette variété.
Des consignes d’annotation claires, des locuteurs natifs formés et des procédures d’assurance qualité permettent de réduire ces incohérences.
Pour les projets d’apprentissage automatique, la cohérence est essentielle. Des annotations insuffisamment normalisées peuvent introduire du bruit dans les données d’entraînement et rendre l’évaluation des modèles moins fiable.
7. Comment les développeurs d’IA peuvent-ils améliorer la reconnaissance vocale arabe ?
L’amélioration de la reconnaissance vocale arabe nécessite une combinaison de meilleures méthodes de collecte de données, d’expertise linguistique, de développement de modèles et d’évaluation systématique.
Plusieurs stratégies peuvent contribuer à atteindre cet objectif :
1. Entraîner les modèles sur plusieurs dialectes arabes
Les données d’entraînement doivent refléter les dialectes que l’application est censée prendre en charge. Les développeurs doivent éviter de supposer qu’un modèle entraîné sur une seule variété de l’arabe comprendra automatiquement toutes les autres.
2. Utiliser des enregistrements de locuteurs natifs
Les enregistrements réalisés auprès de locuteurs natifs fournissent des exemples précieux de prononciation authentique, de vocabulaire et de modèles de parole naturelle. Les participants doivent représenter différentes régions et différents styles de communication.
3. Inclure des exemples de discours avec alternance linguistique
Lorsque cela est pertinent, les jeux de données doivent contenir des exemples réalistes de mélanges entre l’arabe, le français, l’anglais ou d’autres langues. Cette approche est particulièrement importante pour les applications destinées aux communautés multilingues.
4. Appliquer une annotation audio détaillée
Les transcriptions, les étiquettes des locuteurs, les indications de dialecte, les horodatages et les autres métadonnées peuvent améliorer l’exploitation des jeux de données et permettre une évaluation plus approfondie des modèles.
5. Évaluer séparément chaque dialecte
Un seul score global de précision peut masquer des différences importantes entre les groupes dialectaux. Les développeurs doivent évaluer les performances des modèles séparément pour chaque variété ciblée.
Pour la reconnaissance automatique de la parole, le taux d’erreur sur les mots (Word Error Rate ou WER) est une mesure d’évaluation couramment utilisée. Cependant, l’évaluation de l’arabe nécessite également des règles de normalisation précises, car les différentes conventions orthographiques peuvent influencer les résultats.
Le taux d’erreur sur les caractères (Character Error Rate ou CER), les jeux de données d’évaluation spécifiques aux dialectes et la vérification humaine peuvent fournir des informations complémentaires sur les performances des modèles.
8. Les applications concrètes de la reconnaissance des dialectes arabes
La compréhension des dialectes arabes est importante dans un nombre croissant d’applications liées aux technologies vocales.
Assistants vocaux et IA conversationnelle
Les assistants vocaux doivent comprendre les expressions et les particularités de prononciation utilisées par leurs utilisateurs cibles. La prise en charge de plusieurs dialectes arabes peut rendre les interactions plus naturelles et plus accessibles.
Automatisation du service client
Les entreprises opérant sur plusieurs marchés arabophones ont besoin de systèmes vocaux capables de comprendre des clients provenant de différents pays. La reconnaissance vocale adaptée aux dialectes peut améliorer la transcription des appels, l’assistance automatisée et l’analyse des interactions avec les clients.
Transcription et sous-titrage des médias
Les émissions de télévision, les podcasts, les interviews et les vidéos en ligne contiennent fréquemment de l’arabe dialectal. Une reconnaissance précise des dialectes peut faciliter la transcription, la génération de sous-titres et la création d’archives multimédias consultables.
Technologies dans les domaines de la santé et de l’éducation
Les applications vocales destinées à la santé et à l’éducation doivent tenir compte de la manière dont les personnes communiquent naturellement. Une meilleure couverture des dialectes peut rendre les interfaces vocales plus accessibles à différentes communautés, même si ces applications nécessitent également des mesures adaptées en matière de confidentialité, de sécurité et de validation spécifique à leur domaine.
9. Développer une meilleure IA vocale arabe avec Arabica AI Voice
Le développement d’une IA vocale arabe fiable commence par la compréhension des personnes derrière les enregistrements. Les différents dialectes, accents, styles de communication et mélanges linguistiques doivent être représentés dans les données utilisées pour entraîner et évaluer les modèles de reconnaissance vocale.
Chez Arabica AI Voice, nous proposons des services de données linguistiques arabes destinés aux technologies vocales et aux projets de développement en intelligence artificielle.
Nos services peuvent répondre aux besoins des projets nécessitant :
- Collecte de données audio en arabe : Des enregistrements conçus selon des dialectes spécifiques, des profils de locuteurs et les exigences de chaque projet.
- Transcription en arabe : Des transcriptions écrites de contenus oraux en arabe, y compris pour les projets nécessitant une transcription spécifique aux dialectes.
- Annotation audio : Des étiquettes structurées et des métadonnées qui rendent les enregistrements vocaux plus exploitables pour l’apprentissage automatique.
- Couverture des dialectes : Des méthodes de collecte de données qui tiennent compte de la diversité linguistique des communautés arabophones.
- Services de données d’images et multimodales : Une assistance supplémentaire pour la préparation des données destinées aux projets d’IA nécessitant davantage que des données audio.
Que vous développiez un modèle de reconnaissance vocale arabe, un assistant vocal ou une application d’IA conversationnelle multilingue, la qualité et la représentativité de vos données d’entraînement peuvent faire une différence considérable.
Découvrez nos services linguistiques en arabe et nos services de transcription et d’annotation pour savoir comment nous pouvons accompagner votre projet.
10. Questions fréquentes sur les dialectes arabes et l’intelligence artificielle
Combien existe-t-il de dialectes arabes ?
Il n’existe pas de nombre unique et universellement reconnu de dialectes arabes. L’arabe comprend de nombreuses variétés régionales et locales, généralement regroupées en grandes catégories telles que l’arabe maghrébin, égyptien, levantin et du Golfe. Chaque catégorie comprend des différences supplémentaires entre les pays et les communautés.
L’intelligence artificielle peut-elle comprendre tous les dialectes arabes ?
Certains systèmes d’intelligence artificielle prennent en charge plusieurs dialectes arabes, mais leurs performances varient selon le modèle, les données d’entraînement et l’application ciblée. Un système principalement entraîné sur l’arabe standard moderne peut rencontrer des difficultés avec les conversations familières et les variétés régionales moins représentées.
Pourquoi la darija marocaine est-elle difficile à reconnaître pour les systèmes vocaux ?
La darija marocaine possède un vocabulaire particulier, des caractéristiques de prononciation spécifiques et diverses influences linguistiques. Elle comprend également fréquemment des éléments français et amazighs. Ces caractéristiques peuvent compliquer son traitement par les modèles entraînés sur l’arabe formel ou sur d’autres dialectes.
Quelle est la différence entre l’arabe standard moderne et l’arabe dialectal ?
L’arabe standard moderne est la variété normalisée utilisée dans les écrits formels, l’éducation et les communications officielles. L’arabe dialectal désigne les variétés régionales parlées dans les conversations quotidiennes. Ces deux formes présentent des différences de prononciation, de vocabulaire et de grammaire.
Quel type de données est nécessaire pour entraîner des modèles de reconnaissance vocale arabe ?
Les modèles de reconnaissance vocale arabe bénéficient de divers enregistrements audio représentant les dialectes, les locuteurs et les conditions d’enregistrement ciblés. Des transcriptions précises, des étiquettes de locuteurs, des métadonnées dialectales et des consignes d’annotation cohérentes sont également importantes.
Pourquoi l’annotation spécifique aux dialectes est-elle importante ?
L’annotation spécifique aux dialectes permet d’identifier les variations linguistiques et fournit des étiquettes plus précises pour entraîner et évaluer les systèmes d’IA. Elle aide également les développeurs à comprendre les points forts de leurs modèles et les domaines dans lesquels des données supplémentaires sont nécessaires.
L’arabe standard moderne suffit-il pour entraîner un modèle d’IA vocale arabe ?
Cela dépend de l’application visée. L’arabe standard moderne peut suffire pour les systèmes spécialisés dans le traitement des discours formels. Cependant, les applications conçues pour comprendre les conversations quotidiennes nécessitent généralement également des données vocales issues des différents dialectes.
Conclusion : la diversité des dialectes arabes représente un défi pour les données d’IA
La diversité des dialectes arabes constitue l’un des éléments les plus importants à prendre en compte lors du développement de systèmes fiables de reconnaissance vocale arabe. Les différences de vocabulaire, de prononciation, de grammaire et d’alternance linguistique compliquent la compréhension de tous les locuteurs arabophones par les modèles d’IA reposant sur une seule approche d’entraînement standardisée.
La solution commence par l’amélioration des données. Des enregistrements représentatifs, une transcription adaptée aux dialectes, une annotation cohérente et une évaluation couvrant différents groupes de locuteurs permettent de créer des technologies vocales arabes plus fiables et plus inclusives.
À mesure que la demande en intelligence artificielle vocale arabe continue de croître, investir dans des données linguistiques de haute qualité sera essentiel pour développer des systèmes capables de comprendre non seulement l’arabe formel, mais également la langue que les personnes utilisent dans leur vie quotidienne.
Vous développez un projet d’intelligence artificielle vocale en arabe ?
Contactez Arabica AI Voice pour discuter de vos besoins en matière de collecte de données audio, de transcription en arabe et de services d’annotation.