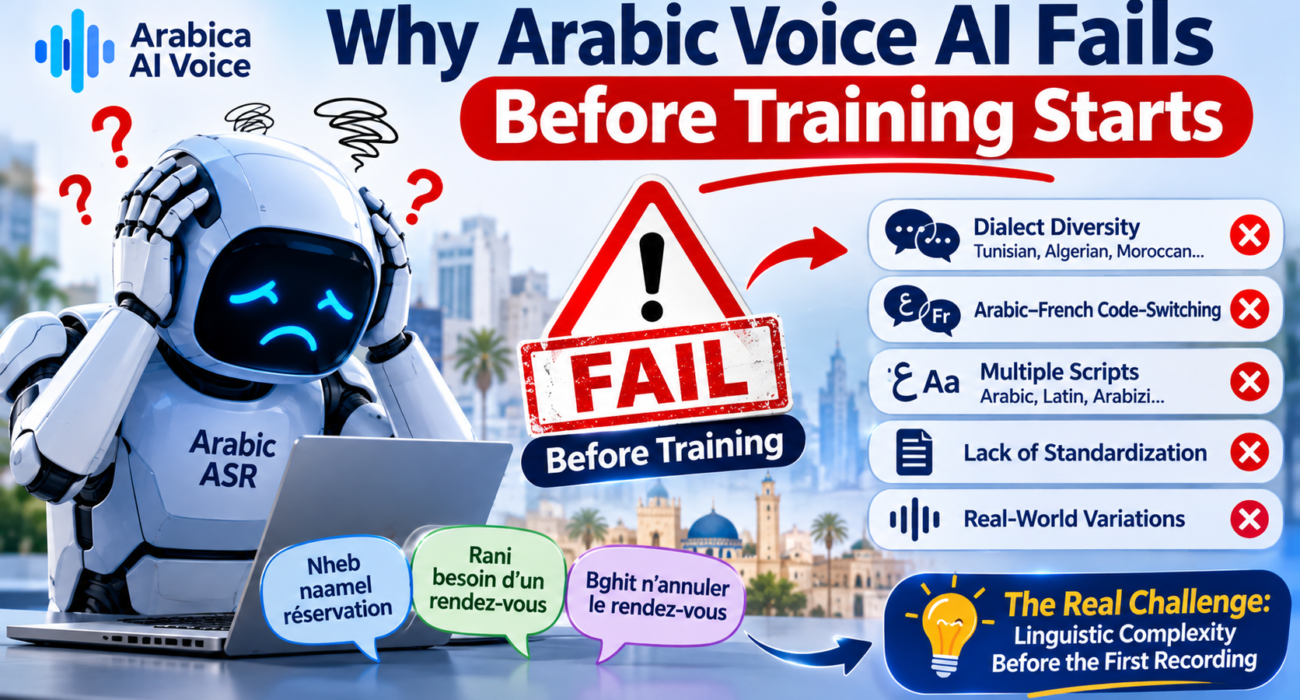
لا يقتصر بناء نظام دقيق للتعرّف على الكلام العربي على اختيار نموذج ذكاء اصطناعي قوي أو زيادة موارد الحوسبة. ففي كثير من الحالات، تظهر أكبر المشكلات قبل وقت طويل من بدء أول عملية تدريب.
تواجه تقنيات معالجة الكلام العربي مجموعة من التحديات الخاصة المرتبطة بتنوع اللهجات، والنطق، وأنظمة الكتابة، والمحادثات متعددة اللغات، وجودة البيانات الصوتية.
قد يحقق نموذج صُمّم للتعرّف على العربية الفصحى الحديثة أداءً جيدًا في التسجيلات الرسمية، لكنه يواجه صعوبة عند التعامل مع المحادثات اليومية باللهجات التونسية أو الجزائرية أو المغربية أو غيرها من اللهجات الإقليمية.
لماذا يحدث ذلك؟
لأن نجاح الذكاء الاصطناعي الصوتي العربي يبدأ بأمور أكثر أساسية من بنية النموذج: فهم اللغة، وتحديد متطلبات البيانات المناسبة، وإعداد مجموعات بيانات صوتية تمثيلية.
في هذا المقال، نستعرض أبرز الأسباب التي قد تؤدي إلى فشل مشاريع الذكاء الاصطناعي الصوتي العربي قبل بدء التدريب، وما ينبغي للمطورين مراعاته لتجنب هذه المشكلات.
1. العربية ليست لغة منطوقة واحدة موحّدة
من أول الأخطاء في تطوير أنظمة الذكاء الاصطناعي للكلام العربي التعامل مع العربية كما لو كانت لغة واحدة متجانسة.
تُستخدم العربية الفصحى الحديثة على نطاق واسع في التواصل الرسمي والتعليم والصحافة والوثائق الرسمية. لكن المحادثات اليومية تعتمد بدرجة كبيرة على اللهجات الإقليمية.
وتختلف هذه اللهجات في المفردات والنطق والتراكيب النحوية والتعبيرات.
فعلى سبيل المثال، يمكن أن تختلف طريقة التعبير عن «أريد» اختلافًا ملحوظًا:
| اللهجة | التعبير | المعنى |
|---|---|---|
| التونسية | Nheb (نحب) | أريد |
| الجزائرية | Nhab (نحب) | أريد |
| الدارجة المغربية | Bghit (بغيت) | أريد |
| المصرية | 3ayez (عايز) | أريد |
قد لا يتمكن نموذج للتعرّف على الكلام دُرّب أساسًا على العربية الفصحى الحديثة من التعرّف على هذه التعبيرات بدقة.
لماذا يشكّل ذلك مشكلة؟
قبل جمع البيانات الصوتية، يجب على المطورين تحديد أنواع العربية التي ينبغي للنظام فهمها.
فالمشروع الذي يستهدف اللهجة التونسية يحتاج إلى موارد لغوية مختلفة عن مشروع يستهدف اللهجة الخليجية أو المصرية.
ومن دون استراتيجية واضحة لتحديد اللهجات المستهدفة، قد لا تمثّل مجموعة البيانات الناتجة المستخدمين الفعليين للنظام.
الحل: تحديد اللهجات المستهدفة، والنطاق الجغرافي، واختلافات النطق، وحالات الاستخدام المقصودة قبل بدء جمع البيانات.
2. غالبًا ما يُستهان بتنوع اللهجات
اللهجات العربية ليست مجرد اختلافات في اللكنة مع بقاء المفردات نفسها؛ إذ يمكن أن تختلف بدرجة كبيرة في التعبيرات اليومية وبناء الجمل وطريقة نطق الكلمات.
تأملوا التعبيرات التالية:
- التونسية: «Chnowa taamel?» (شنوة تعمل؟)
- الجزائرية: «Wach rak dir?» (واش راك دير؟)
- المغربية: «Ach katdir?» (أشنو كتدير؟)
يمكن استخدام التعبيرات الثلاثة للسؤال عمّا يفعله شخص ما، لكنها تختلف في المفردات والنطق.
ويشكّل هذا التنوع تحديًا كبيرًا لأنظمة التعرّف الآلي على الكلام. إذ يحتاج النموذج إلى أمثلة تمثيلية كافية حتى يتعرّف على اختلاف المتحدثين والتعبيرات الإقليمية وأنماط النطق.
أهمية التمثيل الإقليمي
قد لا تمثّل مجموعة بيانات تضم تسجيلات من مدينة واحدة أو من مجموعة صغيرة من المتحدثين لهجةً كاملة تمثيلًا كافيًا.
فعلى سبيل المثال، تختلف اللهجة التونسية من منطقة إلى أخرى، وينطبق الأمر نفسه على اللهجتين الجزائرية والمغربية.
ينبغي للمطورين مراعاة ما يلي:
- الاختلافات الإقليمية في المفردات.
- اختلاف النطق بين المناطق الحضرية والريفية.
- التغيرات اللغوية المرتبطة بالفئات العمرية.
- اختلاف سرعات الكلام.
- التعبيرات الرسمية وغير الرسمية.
- عادات التواصل الطبيعية في المحادثات.
الهدف هو بناء مجموعة بيانات تعكس التنوع اللغوي الحقيقي، لا نسخة موحّدة ومصطنعة من العربية.
3. التبديل بين العربية والفرنسية يزيد التعقيد
يمزج كثير من الناس في شمال إفريقيا العربية والفرنسية بصورة طبيعية ضمن المحادثة نفسها.
وتُعرف هذه الظاهرة باسم «التبديل اللغوي» (Code-switching).
وهي شائعة بشكل خاص في تونس والجزائر والمغرب، حيث تظهر المفردات الفرنسية كثيرًا في التواصل المهني والتعليمي والتقني واليومي.
إليكم بعض الأمثلة:
باللهجة التونسية:
«El réunion mta3 ghodwa, nbadlouha wala nkhaliwha?»
باللهجة الجزائرية:
«Rani besoin d’un rendez-vous.»
بالدارجة المغربية:
«Khassni n’envoyer le document aujourd’hui.»
تجمع هذه الجمل بين اللهجات العربية والمفردات والتعبيرات الفرنسية.
وغالبًا ما يكون فهمها طبيعيًا بالنسبة إلى البشر. أما بالنسبة إلى نظام التعرّف الآلي على الكلام (ASR)، فقد يكون تحديد الانتقال بين اللغات داخل الجملة الواحدة أمرًا صعبًا.
وقد يواجه نموذج دُرّب حصريًا على تسجيلات عربية أو فرنسية صعوبة في التعرّف على هذه التعبيرات المختلطة.
ما الذي ينبغي للمطورين مراعاته؟
قبل بدء التدريب، ينبغي لفرق المشروع تحديد ما إذا كان التبديل بين اللغات جزءًا من بيئة الكلام المستهدفة.
إذا كان الأمر كذلك، فيجب أن تتضمن مجموعة البيانات ما يلي:
- جملًا مختلطة بالعربية والفرنسية.
- أنماطًا مختلفة لنطق الكلمات الفرنسية.
- تراكيب نحوية خاصة باللهجات.
- مفردات تقنية ومهنية.
- محادثات طبيعية، لا جملًا مكتوبة مسبقًا فقط.
يساعد ذلك على تعريض النموذج للطريقة التي يتواصل بها الناس في الواقع.
4. عدم اتساق أنظمة كتابة العربية وتفريغ الكلام
يظهر تحدٍ مهم آخر عندما يكون من الضروري تحويل الكلام العربي المنطوق إلى نص مكتوب.
فعلى خلاف الإنجليزية أو الفرنسية، لا تعتمد كثير من اللهجات العربية طريقة إملائية موحّدة ومتفقًا عليها عالميًا.
وبحسب المتحدث والسياق، يمكن كتابة العربية الدارجة بالحروف العربية أو بالحروف اللاتينية أو باستخدام «العربيزي» (Arabizi).
على سبيل المثال:
- بالحروف العربية: نحب نمشي
- النقل الحرفي اللاتيني: Nheb nemchi
- العربيزي: N7eb nemchi
تمثّل هذه الصيغ التعبير التونسي نفسه: «أريد أن أذهب»، لكنها تختلف في طريقة الكتابة.
لماذا يُعد اتساق التفريغ النصي مهمًا؟
تعتمد نماذج التعرّف على الكلام على أمثلة تدريبية تربط التسجيلات الصوتية بالنصوص المكتوبة المقابلة لها.
إذا ظهر التعبير نفسه بعدة صيغ إملائية مختلفة من دون قواعد واضحة للتوسيم، فقد تصبح مجموعة البيانات غير متسقة.
ويؤدي ذلك إلى صعوبات أثناء تدريب النموذج وتقييمه.
وضع معايير موحّدة للتفريغ النصي
قبل جمع كميات كبيرة من التسجيلات الصوتية وتوسيمها، ينبغي للفرق تحديد ما يلي:
- نظام الكتابة المفضّل.
- كيفية تمثيل مفردات اللهجات.
- ما إذا كانت الكلمات الفرنسية ستُكتب بإملائها الأصلي.
- كيفية التعامل مع تعبيرات العربيزي.
- كيفية تفريغ الأرقام والاختصارات.
- كيفية تمثيل الكلمات المكررة والجمل غير المكتملة.
تجعل سياسة التفريغ النصي المتسقة مجموعة البيانات أسهل في الإدارة والتحقق والاستخدام.
5. قد تؤثر رداءة جودة البيانات الصوتية في المشروع بأكمله
حتى عندما تكون اللهجة المستهدفة محددة بوضوح، يمكن أن تؤثر جودة التسجيل الضعيفة سلبًا في مدى فائدة مجموعة البيانات الصوتية.
فقد يحتوي التسجيل على كلام صحيح، لكنه يظل غير مناسب لتطبيق معين من تطبيقات الذكاء الاصطناعي.
تشمل المشكلات الشائعة:
- ضوضاء الخلفية.
- الصدى والتداخل الناتج عن الميكروفون.
- انخفاض مستوى صوت التسجيل.
- تشوّه الصوت.
- الجمل غير المكتملة.
- المقاطع الصوتية المفقودة.
- عدم اتساق صيغ التسجيل.
فعلى سبيل المثال، قد تختلف جودة التسجيلات التي جُمعت باستخدام أجهزة محمولة متعددة وفي بيئات غير مضبوطة اختلافًا كبيرًا.
ولا تُعد هذه الاختلافات سيئة بالضرورة؛ بل قد تكون الظروف الصوتية الواقعية مفيدة لبعض التطبيقات. لكن يجب ضبطها وتوثيقها وفقًا لأهداف المشروع.
يجب تحديد المواصفات التقنية أولًا
قبل بدء التسجيل، ينبغي للمطورين تحديد المتطلبات التالية:
- معدل أخذ العينات (Sampling Rate).
- عمق البت للصوت (Audio Bit Depth).
- صيغة التسجيل.
- إعداد القناة الصوتية: أحادية أم ستيريو.
- الحد الأقصى المقبول لضوضاء الخلفية.
- مدة التسجيل.
- متطلبات الميكروفون.
يجب أن تتوافق هذه المواصفات مع التطبيق المستهدف، لا أن يتم اختيارها عشوائيًا.
يساعد بروتوكول التسجيل المصمم جيدًا على الحد من المشكلات التقنية التي يمكن تجنبها.
6. اختيار المتحدثين غير المناسبين يؤدي إلى مجموعات بيانات ضعيفة
تعتمد جودة مجموعة البيانات الصوتية العربية أيضًا على الأشخاص المشاركين في عملية التسجيل.
إن اختيار متحدثين من دون مراعاة المتطلبات اللغوية للمشروع قد يؤدي إلى مجموعة بيانات لا تمثّل الواقع.
فعلى سبيل المثال، ينبغي لمشروع يستهدف اللهجة التونسية ألا يعتمد حصريًا على متحدثين يستخدمون العربية الفصحى الحديثة أو لهجة إقليمية أخرى في المقام الأول.
ما الذي يجعل ملف المتحدث تمثيليًا؟
بحسب أهداف المشروع، يمكن أن تشمل معايير اختيار المشاركين ما يلي:
- متحدثون أصليون باللهجة المستهدفة أو متقنون لها.
- مناطق جغرافية مختلفة.
- فئات عمرية متنوعة.
- تمثيل الجنسين.
- مستويات تعليمية مختلفة.
- متحدثون ثنائيو اللغة العربية والفرنسية.
- خلفيات مهنية متنوعة.
ينبغي تحديد معايير الاختيار الدقيقة بناءً على المستخدمين المستهدفين وطبيعة التطبيق.
لماذا يُعد تنوع المتحدثين مهمًا؟
يجب أن يكون نظام التعرّف على الكلام قادرًا على التعرّف على أكثر من طريقة نطق لشخص واحد.
بل ينبغي تعريضه للاختلافات الطبيعية في أساليب الكلام واللهجات والمفردات والأنماط الصوتية.
وقد توفر مجموعة بيانات تضم ساعات كثيرة من التسجيلات لعدد محدود من المتحدثين تنوعًا لغويًا أقل من مجموعة أصغر حجمًا، لكنها مصممة بعناية وتشمل مشاركين من خلفيات أوسع.
7. غياب إرشادات التوسيم يسبب مشكلات قبل التدريب
يُعد توسيم البيانات الصوتية مرحلة أساسية أخرى ينبغي التخطيط لها قبل بدء جمع البيانات.
توفر التعليقات والتوسيمات معلومات إضافية عن الكلام المسجّل، وتساعد على تنظيم مجموعة البيانات لاستخدامها في تطبيقات التعلم الآلي.
وبحسب المشروع، قد تشمل البيانات الموسومة ما يلي:
- الكلمات المنطوقة بدقة.
- تحديد هوية المتحدث.
- الطوابع الزمنية على مستوى الكلمات.
- حدود الجمل.
- تحديد اللغة.
- تحديد اللهجة.
- الأصوات غير الكلامية.
- معلومات عن ضوضاء الخلفية.
من دون إرشادات واضحة، قد يفسّر المساهمون في التوسيم التسجيل نفسه بطرق مختلفة.
فعلى سبيل المثال، قد يكتب أحدهم تعبيرًا تونسيًا بالحروف العربية، بينما يكتبه شخص آخر بالنقل الحرفي اللاتيني.
وعلى الرغم من أن الصيغتين قد تكونان مفهومتين لغويًا، فإن عدم الاتساق قد يسبب مشكلات لمجموعة البيانات.
أهمية توثيق قواعد التوسيم
قبل بدء التوسيم، ينبغي لفرق المشروع وضع قواعد تشمل:
- قواعد التفريغ النصي.
- قواعد المفردات الخاصة بكل لهجة.
- معايير وضع تسميات المتحدثين.
- متطلبات الطوابع الزمنية.
- قواعد توثيق التبديل بين اللغات.
- إجراءات مراجعة الجودة.
تحسّن الإرشادات الواضحة الاتساق وتقلل الحاجة إلى إجراء تصحيحات واسعة لاحقًا.
8. قصور التخطيط لمجموعة البيانات وتغطيتها
من الأسباب الأخرى التي تجعل مشاريع الذكاء الاصطناعي الصوتي العربي تواجه صعوبات غياب استراتيجية واضحة لجمع البيانات.
فجمع كمية كبيرة من التسجيلات لا يؤدي تلقائيًا إلى إنشاء مجموعة بيانات عالية الجودة.
قد يجمع المشروع آلاف الساعات من الصوت، ومع ذلك يفتقر إلى فئات لغوية مهمة.
فعلى سبيل المثال، قد تحتوي المجموعة على:
- عدد كبير جدًا من التسجيلات من منطقة واحدة.
- تمثيل غير كافٍ لبعض اللهجات.
- عدد محدود من المحادثات التي تمزج الفرنسية والعربية.
- قلة المحادثات العفوية.
- جمل مكتوبة مسبقًا ومتكررة.
- تنوع غير كافٍ بين المتحدثين.
لهذا السبب، ينبغي أن يركّز تخطيط مجموعة البيانات على التغطية والتمثيل، لا على حجم التسجيلات وحده.
إنشاء مصفوفة لتغطية مجموعة البيانات
قبل إطلاق عملية استقطاب المشاركين، يمكن للمطورين إعداد مصفوفة تغطية لتحديد الفئات المطلوبة.
| بُعد مجموعة البيانات | أمثلة |
|---|---|
| اللغة | العربية، الفرنسية، الكلام المختلط |
| اللهجة | التونسية، الجزائرية، المغربية |
| نوع الكلام | مكتوب مسبقًا، عفوي، حواري |
| اللكنة | اختلافات النطق الإقليمية |
| المتحدثون | ملفات متنوعة للمشاركين |
| البيئة | استوديو، مكتب، هاتف محمول |
| المفردات | يومية، تقنية، طبية |
يساعد هذا النهج على اكتشاف الفئات الناقصة قبل أن تتحول إلى مشكلات مكلفة.
9. يجب مراعاة الخصوصية والموافقة منذ البداية
التسجيلات الصوتية ليست ملفات رقمية عادية.
فقد يكون صوت الشخص وسيلة للتعرّف على هويته، كما قد تتضمن التسجيلات معلومات شخصية أو حساسة.
لذلك، يجب التفكير في الخصوصية والموافقة قبل بدء استقطاب المشاركين والتسجيل.
ينبغي لمشروع مسؤول لجمع البيانات الصوتية أن يحدد ما يلي:
- الغرض من جمع البيانات.
- الاستخدام المقصود للتسجيلات.
- الأساس القانوني لمعالجة البيانات الشخصية.
- إجراءات إعلام المشاركين والحصول على موافقتهم، عندما تكون الموافقة هي الأساس القانوني المعتمد.
- ضوابط تخزين البيانات والوصول إليها.
- فترات الاحتفاظ بالبيانات.
- الإجراءات المعمول بها لسحب الموافقة والحذف، بحسب الحالة.
- قواعد مشاركة التسجيلات مع أطراف ثالثة مخوّلة.
بالنسبة إلى المشاريع التي تتضمن بيانات شخصية، يجب مراعاة اللوائح المعمول بها، مثل اللائحة العامة لحماية البيانات (GDPR) أو قوانين حماية البيانات الوطنية ذات الصلة.
ينبغي دمج هذه المتطلبات في تصميم المشروع منذ البداية، لا إضافتها في مرحلة لاحقة.
10. كيفية إعداد مجموعة بيانات للكلام العربي قبل التدريب
يتطلب نجاح مشروع الذكاء الاصطناعي الصوتي العربي عملية إعداد منظّمة.
وقبل إطلاق تدريب النموذج، ينبغي للفرق إتمام عدة مراحل أساسية.
الخطوة 1: تحديد التطبيق المستهدف
حدّد ما إذا كان المشروع مخصصًا لأحد الاستخدامات التالية:
- التعرّف الآلي على الكلام (ASR).
- المساعدات الصوتية.
- تطبيقات تحويل الكلام إلى نص.
- أتمتة مراكز الاتصال.
- البحث الصوتي.
- تحليلات الكلام.
- تحويل النص إلى كلام (TTS).
قد يتطلب كل تطبيق خصائص مختلفة للبيانات.
الخطوة 2: تحديد اللهجات المستهدفة
حدّد اللهجات العربية والاختلافات الإقليمية التي يجب تمثيلها.
تجنّب التعامل مع جميع المتحدثين بالعربية كما لو كانوا فئة لغوية واحدة.
الخطوة 3: تحديد معايير استقطاب المشاركين
ضع ملفات تعريف للمتحدثين تعكس الجمهور المستهدف.
الخطوة 4: وضع بروتوكولات التسجيل
حدّد مواصفات الصوت وبيئات التسجيل والنصوص المطلوب قراءتها ومتطلبات الكلام العفوي.
الخطوة 5: إعداد إرشادات التفريغ النصي والتوسيم
تأكد من أن جميع التسجيلات تتبع معايير لغوية وتقنية متسقة.
الخطوة 6: تطبيق مراقبة الجودة
ضع إجراءات لمراجعة جودة الصوت ودقة التفريغ النصي واتساق التوسيم واكتمال مجموعة البيانات.
الخطوة 7: التحقق من تغطية مجموعة البيانات
تحقق مما إذا كانت التسجيلات التي جُمعت تمثّل اللهجات والمتحدثين وسيناريوهات التواصل المستهدفة تمثيلًا كافيًا.
الخطوة 8: تجهيز مجموعة البيانات للتسليم والتدريب
نظّم الملفات الصوتية والنصوص المفرّغة والتوسيمات والبيانات الوصفية والوثائق ضمن حزمة منظّمة.
ولا ينبغي نقل مجموعة البيانات إلى مسار تدريب النموذج إلا بعد إتمام مراحل الإعداد هذه.
11. الأساس الحقيقي للذكاء الاصطناعي الصوتي العربي
لا يعتمد نجاح تقنيات الصوت العربي على الخوارزميات المتقدمة وحدها.
بل يتطلب فهمًا عميقًا للطريقة التي يتواصل بها المتحدثون بالعربية في حياتهم اليومية.
فالتنوع اللهجي، والتبديل بين اللغات، وقواعد التفريغ النصي، وجودة التسجيل، وتمثيل المتحدثين، كلها عوامل تؤثر في مدى فائدة بيانات التدريب.
في Arabica AI Voice، يُعد التنوع اللغوي العربي عنصرًا مهمًا عند دراسة البيانات الصوتية وحلول الذكاء الاصطناعي الصوتي.
ويبدأ بناء تقنيات صوتية عربية أفضل بطرح الأسئلة الصحيحة:
- ما اللهجات التي نستهدفها؟
- من هم المتحدثون المشاركون؟
- كيف يتواصلون بصورة طبيعية؟
- ما اللغات التي يمزجون بينها؟
- كيف سيتم تفريغ كلامهم إلى نص؟
- هل تعكس مجموعة البيانات التواصل في العالم الحقيقي؟
ينبغي الإجابة عن هذه الأسئلة قبل جمع أول تسجيل صوتي، لا بعد أن يفشل النموذج في التعرّف على الكلام المستهدف.
الذكاء الاصطناعي الصوتي العربي الأفضل يبدأ قبل التدريب
قد تواجه مشاريع الذكاء الاصطناعي الصوتي العربي صعوبات كبيرة حتى قبل بدء تدريب النموذج.
وغالبًا ما ترتبط الأسباب الأساسية بعدم كفاية تغطية اللهجات، وعدم اتساق التفريغ النصي، ومحدودية تنوع المتحدثين، وضعف بروتوكولات التسجيل، وقصور التخطيط لمجموعة البيانات.
ولا يمكن دائمًا حل هذه المشكلات باختيار نموذج أكثر تطورًا أو زيادة القدرة الحاسوبية.
بل يجب بناء الأساس بصورة صحيحة منذ البداية.
ومن خلال تحديد المتطلبات اللغوية، واستقطاب متحدثين يمثّلون الفئات المستهدفة، ووضع معايير واضحة للتوسيم، وتطبيق مراقبة صارمة للجودة، يستطيع المطورون إنشاء مجموعات بيانات صوتية عربية أكثر فائدة وموثوقية.
الذكاء الاصطناعي الصوتي العربي الأفضل لا يبدأ بالتدريب، بل يبدأ بفهم الأصوات واللهجات والأشخاص الذين تقف أصواتهم وراء البيانات.