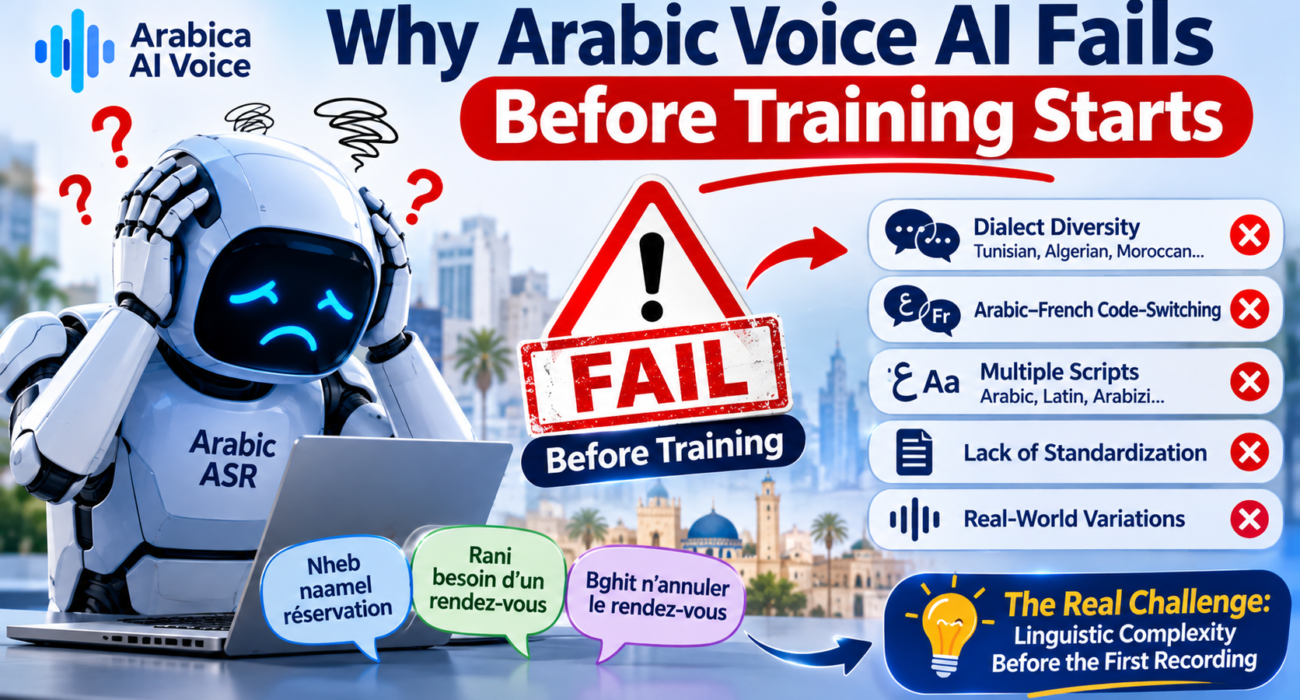
Créer un système précis de reconnaissance vocale en arabe ne consiste pas simplement à choisir un modèle d’IA puissant ou à augmenter les ressources informatiques. Dans de nombreux cas, les principaux problèmes apparaissent bien avant le début de la première session d’entraînement.
Les technologies vocales en arabe font face à des défis spécifiques liés à la diversité des dialectes, à la prononciation, aux systèmes d’écriture, aux conversations multilingues et à la qualité des données vocales.
Un modèle conçu pour reconnaître l’arabe standard moderne peut obtenir de bons résultats sur des enregistrements formels, mais rencontrer des difficultés lorsqu’il est exposé à des conversations quotidiennes en tunisien, algérien, marocain ou dans d’autres dialectes régionaux arabes.
Pourquoi cela se produit-il ?
Parce que la réussite d’une solution d’IA vocale en arabe repose sur des éléments plus fondamentaux que l’architecture du modèle : comprendre la langue, définir les bonnes exigences en matière de données et préparer des jeux de données vocaux représentatifs.
Dans cet article, nous explorons les principales raisons pour lesquelles les projets d’IA vocale en arabe peuvent échouer avant même le début de l’entraînement, ainsi que les éléments que les développeurs doivent prendre en compte pour éviter ces problèmes.
1. L’arabe n’est pas une seule langue parlée
L’une des premières erreurs dans le développement de l’IA vocale en arabe consiste à traiter l’arabe comme une langue unique et uniforme.
L’arabe standard moderne (ASM) est largement utilisé dans la communication formelle, l’éducation, le journalisme et les documents officiels. Cependant, les conversations quotidiennes se déroulent principalement dans les dialectes régionaux.
Ces dialectes présentent des différences de vocabulaire, de prononciation, de structures grammaticales et d’expressions.
Par exemple, l’expression « Je veux » peut varier considérablement :
| Dialecte | Expression | Signification |
|---|---|---|
| Arabe tunisien | Nheb (نحب) | Je veux |
| Arabe algérien | Nhab (نحب) | Je veux |
| Darija marocaine | Bghit (بغيت) | Je veux |
| Arabe égyptien | 3ayez (عايز) | Je veux |
Un modèle de reconnaissance vocale entraîné principalement sur l’arabe standard moderne risque de ne pas reconnaître correctement ces expressions.
Pourquoi cela pose-t-il un problème ?
Avant de collecter des données vocales, les développeurs doivent déterminer quelles variétés de l’arabe le système devra comprendre.
Un projet ciblant l’arabe tunisien nécessite des ressources linguistiques différentes de celles d’un projet ciblant l’arabe du Golfe ou l’arabe égyptien.
Sans stratégie clairement définie concernant les dialectes, le jeu de données obtenu risque de ne pas représenter les véritables utilisateurs du système.
La solution : définir les dialectes ciblés, la couverture géographique, les variations de prononciation et les cas d’usage prévus avant de commencer la collecte des données.
2. La diversité des dialectes est souvent sous-estimée
Les dialectes arabes ne sont pas simplement des accents différents utilisant le même vocabulaire.
Ils peuvent présenter des différences importantes dans les expressions courantes, la construction des phrases et la prononciation des mots.
Considérons les expressions suivantes :
- Tunisien : « Chnowa taamel ? » (شنوة تعمل؟)
- Algérien : « Wach rak dir ? » (واش راك دير؟)
- Marocain : « Ach katdir ? » (أشنو كتدير؟)
Ces trois expressions peuvent être utilisées pour demander à quelqu’un ce qu’il est en train de faire.
Leur vocabulaire et leur prononciation sont toutefois différents.
Pour un système d’IA de reconnaissance vocale, ces variations représentent un défi majeur.
Un modèle a besoin d’un nombre suffisant d’exemples représentatifs pour reconnaître différents locuteurs, expressions régionales et schémas de prononciation.
L’importance de la représentation régionale
Un jeu de données contenant des enregistrements provenant d’une seule ville ou d’un petit groupe de locuteurs peut ne pas représenter correctement un dialecte dans son ensemble.
Par exemple, l’arabe tunisien peut varier d’une région à l’autre. Il en va de même pour l’arabe algérien et l’arabe marocain.
Les développeurs devraient prendre en compte :
- Les différences régionales de vocabulaire.
- La prononciation en milieu urbain et rural.
- Les variations linguistiques liées à l’âge.
- Les différents rythmes de parole.
- Les expressions formelles et informelles.
- Les habitudes naturelles de conversation.
L’objectif est de construire un jeu de données qui reflète la véritable diversité linguistique, plutôt qu’une version artificiellement uniforme de l’arabe.
3. L’alternance entre le français et l’arabe ajoute une complexité supplémentaire
En Afrique du Nord, de nombreuses personnes mélangent naturellement l’arabe et le français au cours d’une même conversation.
Ce phénomène est appelé alternance codique, ou code-switching.
Il est particulièrement courant en Tunisie, en Algérie et au Maroc, où le vocabulaire français apparaît fréquemment dans les échanges professionnels, éducatifs, techniques et quotidiens.
Considérons ces exemples :
Arabe tunisien :
« El réunion mta3 ghodwa, nbadlouha wala nkhaliwha ? »
Arabe algérien :
« Rani besoin d’un rendez-vous. »
Darija marocaine :
« Khassni n’envoyer le document aujourd’hui. »
Ces phrases combinent des dialectes arabes avec du vocabulaire et des expressions françaises.
Pour un être humain, leur compréhension est généralement naturelle.
Pour un système de reconnaissance automatique de la parole (ASR), en revanche, identifier les changements de langue au sein d’une même phrase peut être difficile.
Un modèle entraîné exclusivement sur des enregistrements en arabe ou en français peut avoir du mal à reconnaître ces expressions mixtes.
Que doivent prendre en compte les développeurs ?
Avant le début de l’entraînement, les équipes projet doivent déterminer si l’alternance codique fait partie de l’environnement vocal ciblé.
Si c’est le cas, le jeu de données doit inclure :
- Des phrases mélangeant l’arabe et le français.
- Différentes façons de prononcer les mots français.
- Des structures grammaticales propres aux dialectes.
- Du vocabulaire technique et professionnel.
- Des conversations naturelles, et pas uniquement des phrases préparées.
Cela permet de garantir que le modèle est exposé à la manière dont les gens communiquent réellement.
4. Les systèmes d’écriture et de transcription de l’arabe manquent d’uniformité
Un autre défi important apparaît lorsque la parole arabe doit être convertie en texte écrit.
Contrairement à l’anglais ou au français, de nombreux dialectes arabes ne disposent pas d’une convention orthographique universellement adoptée.
Selon le locuteur et le contexte, l’arabe dialectal peut être écrit en caractères arabes, en caractères latins ou en Arabizi.
Par exemple :
- Écriture arabe : نحب نمشي
- Translittération latine : Nheb nemchi
- Arabizi : N7eb nemchi
Ces formes représentent la même expression tunisienne : « Je veux partir ».
Il s’agit toutefois de représentations écrites différentes.
Pourquoi la cohérence de la transcription est-elle importante ?
Les modèles de reconnaissance vocale s’appuient sur des exemples d’entraînement qui associent des enregistrements audio à des transcriptions écrites.
Si une même expression apparaît sous plusieurs formes orthographiques sans règles d’annotation claires, le jeu de données risque de devenir incohérent.
Cela complique l’entraînement et l’évaluation du modèle.
Établir des normes de transcription
Avant de collecter et d’annoter de grands volumes d’audio, les équipes doivent définir :
- Le système d’écriture à privilégier.
- La manière de représenter le vocabulaire dialectal.
- La conservation ou non de l’orthographe originale des mots français.
- La manière de traiter les expressions en Arabizi.
- La transcription des nombres et des abréviations.
- La représentation des mots répétés et des phrases inachevées.
Une politique de transcription cohérente facilite la gestion, la validation et l’utilisation du jeu de données.
5. Une mauvaise qualité des données vocales peut compromettre tout le projet
Même lorsque le dialecte ciblé est clairement défini, une mauvaise qualité d’enregistrement peut réduire considérablement l’utilité d’un jeu de données vocales.
Un enregistrement peut contenir une parole parfaitement correcte tout en étant inadapté à une application d’IA donnée.
Les problèmes courants comprennent :
- Le bruit de fond.
- L’écho et les interférences du microphone.
- Un volume d’enregistrement trop faible.
- La distorsion audio.
- Les phrases incomplètes.
- Les segments audio manquants.
- Les formats d’enregistrement incohérents.
Par exemple, des enregistrements réalisés avec différents appareils mobiles dans des environnements non contrôlés peuvent présenter des différences importantes de qualité audio.
Ces variations ne sont pas nécessairement mauvaises. En réalité, des conditions audio réalistes peuvent être utiles pour certaines applications.
Elles doivent toutefois être maîtrisées et documentées en fonction des objectifs du projet.
Les spécifications techniques doivent être définies en premier
Avant le début des enregistrements, les développeurs doivent définir les éléments suivants :
- La fréquence d’échantillonnage.
- La profondeur de bits audio.
- Le format d’enregistrement.
- La configuration mono ou stéréo.
- Le niveau maximal de bruit de fond.
- La durée des enregistrements.
- Les exigences relatives aux microphones.
Les spécifications doivent correspondre à l’application visée, plutôt que d’être choisies au hasard.
Un protocole d’enregistrement bien conçu permet de réduire les problèmes techniques évitables.
6. Recruter les mauvais locuteurs conduit à des jeux de données peu représentatifs
La qualité d’un jeu de données vocales en arabe dépend également des personnes qui participent au processus d’enregistrement.
Recruter des locuteurs sans tenir compte des exigences linguistiques du projet peut produire un jeu de données qui ne représente pas fidèlement la population ciblée.
Par exemple, un projet consacré à l’arabe tunisien ne devrait pas s’appuyer exclusivement sur des locuteurs qui utilisent principalement l’arabe standard moderne ou un autre dialecte régional.
Qu’est-ce qui caractérise un profil de locuteur représentatif ?
Selon les objectifs du projet, les critères de recrutement peuvent inclure :
- Des locuteurs natifs ou maîtrisant parfaitement le dialecte.
- Différentes régions géographiques.
- Différentes tranches d’âge.
- Une représentation des genres.
- Différents niveaux d’éducation.
- Des locuteurs bilingues arabe-français.
- Différents milieux professionnels.
Les critères exacts de sélection doivent être définis en fonction des utilisateurs visés et de l’application.
Pourquoi la diversité des locuteurs est-elle importante ?
Un système de reconnaissance vocale doit reconnaître bien plus que la prononciation d’une seule personne.
Il doit être exposé aux différences naturelles de style de parole, d’accent, de vocabulaire et de rythme.
Un jeu de données contenant de nombreuses heures d’enregistrements provenant de seulement quelques locuteurs peut offrir moins de diversité linguistique qu’une collection plus réduite, mais soigneusement conçue, réunissant un éventail plus large de participants.
7. L’absence de consignes d’annotation crée des problèmes avant l’entraînement
L’annotation vocale est une autre étape essentielle qui doit être planifiée avant le début de la collecte des données.
Les annotations apportent des informations supplémentaires sur la parole enregistrée et permettent d’organiser le jeu de données pour les applications d’apprentissage automatique.
Selon le projet, les annotations peuvent inclure :
- Les mots prononcés exactement.
- L’identification des locuteurs.
- Les horodatages au niveau des mots.
- Les limites des phrases.
- L’identification de la langue.
- L’identification du dialecte.
- Les sons non verbaux.
- Les informations relatives au bruit de fond.
Sans consignes claires, différents annotateurs peuvent interpréter un même enregistrement de manière différente.
Par exemple, un annotateur peut transcrire une expression tunisienne en caractères arabes, tandis qu’un autre utilise une translittération latine.
Même si les deux transcriptions sont compréhensibles sur le plan linguistique, cette incohérence peut poser des problèmes pour le jeu de données.
L’importance de la documentation des annotations
Avant le début de l’annotation, les équipes projet doivent établir :
- Les conventions de transcription.
- Les règles relatives au vocabulaire propre à chaque dialecte.
- Les normes d’identification des locuteurs.
- Les exigences concernant les horodatages.
- Les règles d’annotation de l’alternance codique.
- Les procédures de contrôle qualité.
Des consignes claires améliorent la cohérence et réduisent le besoin de corrections importantes par la suite.
8. Une planification et une couverture insuffisantes du jeu de données
Une autre raison pour laquelle les projets d’IA vocale en arabe rencontrent des difficultés est l’absence d’une stratégie claire de collecte des données.
Collecter un grand volume d’enregistrements ne garantit pas automatiquement la qualité du jeu de données.
Un projet peut recueillir des milliers d’heures d’audio tout en ne couvrant pas certaines catégories linguistiques essentielles.
Par exemple, il peut contenir :
- Trop d’enregistrements provenant d’une seule région.
- Une représentation insuffisante de certains dialectes.
- Peu d’exemples d’alternance entre le français et l’arabe.
- Peu de conversations spontanées.
- Des phrases préparées répétitives.
- Une diversité insuffisante de locuteurs.
C’est pourquoi la planification d’un jeu de données doit privilégier la couverture et la représentativité, et pas uniquement le volume des enregistrements.
Construire une matrice de couverture du jeu de données
Avant de lancer le recrutement, les développeurs peuvent créer une matrice de couverture afin d’identifier les catégories nécessaires.
| Dimension du jeu de données | Exemples |
|---|---|
| Langue | Arabe, français, parole mixte |
| Dialecte | Tunisien, algérien, marocain |
| Type de parole | Préparée, spontanée, conversationnelle |
| Accent | Variations régionales de prononciation |
| Locuteurs | Différents profils de participants |
| Environnement | Studio, bureau, mobile |
| Vocabulaire | Courant, technique, médical |
Cette approche permet d’identifier les catégories manquantes avant qu’elles ne deviennent des problèmes coûteux.
9. La confidentialité et le consentement doivent être pris en compte dès le départ
Les enregistrements vocaux ne sont pas de simples fichiers numériques.
La voix d’une personne peut permettre de l’identifier, et les enregistrements peuvent contenir des informations personnelles ou sensibles.
La confidentialité et le consentement doivent donc être pris en compte avant le recrutement des participants et le début des enregistrements.
Un projet responsable de collecte de données vocales doit définir :
- L’objectif de la collecte des données.
- L’utilisation prévue des enregistrements.
- La base juridique du traitement des données personnelles.
- Les procédures d’information et de consentement des participants, lorsque le consentement constitue la base juridique applicable.
- Les règles de stockage et de contrôle d’accès aux données.
- Les durées de conservation des données.
- Les procédures applicables de retrait et de suppression.
- Les règles de partage des enregistrements avec des tiers autorisés.
Pour les projets impliquant des données personnelles, il faut tenir compte des réglementations applicables, telles que le RGPD ou les lois nationales pertinentes en matière de protection des données.
Ces exigences doivent être intégrées dès la conception du projet, et non ajoutées après coup.
10. Comment préparer un jeu de données vocales en arabe avant l’entraînement
La réussite d’un projet d’IA vocale en arabe nécessite un processus de préparation structuré.
Avant de lancer l’entraînement du modèle, les équipes doivent franchir plusieurs étapes importantes.
Étape 1 : définir l’application cible
Déterminez si le projet est destiné à :
- La reconnaissance automatique de la parole (ASR).
- Des assistants vocaux.
- Des applications de conversion de la parole en texte.
- L’automatisation des centres d’appels.
- La recherche vocale.
- L’analyse de la parole.
- La synthèse vocale (TTS).
Chaque application peut nécessiter des caractéristiques de données différentes.
Étape 2 : identifier les dialectes ciblés
Déterminez quels dialectes arabes et quelles variations régionales doivent être représentés.
Évitez de traiter tous les locuteurs arabophones comme une seule catégorie linguistique.
Étape 3 : définir les critères de recrutement
Établissez des profils de locuteurs qui reflètent le public visé.
Étape 4 : établir les protocoles d’enregistrement
Définissez les spécifications audio, les environnements d’enregistrement, les scripts et les exigences relatives à la parole spontanée.
Étape 5 : créer des consignes de transcription et d’annotation
Veillez à ce que tous les enregistrements respectent des normes linguistiques et techniques cohérentes.
Étape 6 : mettre en place un contrôle qualité
Établissez des procédures de vérification de la qualité audio, de l’exactitude des transcriptions, de la cohérence des annotations et de l’exhaustivité du jeu de données.
Étape 7 : valider la couverture du jeu de données
Vérifiez si les enregistrements collectés représentent suffisamment les dialectes, les locuteurs et les situations de communication ciblés.
Étape 8 : préparer le jeu de données pour sa livraison et son entraînement
Organisez les fichiers audio, les transcriptions, les annotations, les métadonnées et la documentation dans un ensemble structuré.
Ce n’est qu’après ces étapes de préparation que le jeu de données devrait intégrer le processus d’entraînement du modèle.
11. Les véritables fondations de l’IA vocale en arabe
La réussite des technologies vocales en arabe dépend de bien plus que d’algorithmes avancés.
Elle exige une compréhension approfondie de la manière dont les arabophones communiquent dans la vie réelle.
La diversité des dialectes, l’alternance codique, les conventions de transcription, la qualité des enregistrements et la représentativité des locuteurs influencent tous l’utilité des données d’entraînement.
Chez Arabic AI Voice, la diversité linguistique de l’arabe est un élément important dans l’exploration des données vocales et des solutions d’IA vocale.
Construire de meilleures technologies vocales en arabe commence par les bonnes questions :
- Quels dialectes ciblons-nous ?
- Qui sont les locuteurs ?
- Comment communiquent-ils naturellement ?
- Quelles langues mélangent-ils ?
- Comment leur parole sera-t-elle transcrite ?
- Le jeu de données reflète-t-il la communication dans des situations réelles ?
Ces questions doivent trouver une réponse avant la collecte du premier enregistrement, et non après l’échec d’un modèle à reconnaître la parole ciblée.
Une meilleure IA vocale en arabe commence avant l’entraînement
Les projets d’IA vocale en arabe peuvent rencontrer de sérieuses difficultés avant même le début de l’entraînement du modèle.
Les causes profondes sont souvent liées à une couverture insuffisante des dialectes, à des transcriptions incohérentes, à une diversité limitée des locuteurs, à de mauvais protocoles d’enregistrement et à une planification inadéquate des jeux de données.
Ces problèmes ne peuvent pas toujours être résolus en choisissant un modèle plus avancé ou en augmentant la puissance de calcul.
Les fondations doivent être correctement établies dès le départ.
En définissant les exigences linguistiques, en recrutant des locuteurs représentatifs, en établissant des normes d’annotation claires et en mettant en place un contrôle qualité rigoureux, les développeurs peuvent créer des jeux de données vocaux arabes plus utiles et plus fiables.
Une meilleure IA vocale en arabe ne commence pas par l’entraînement. Elle commence par la compréhension des voix, des dialectes et des personnes qui se trouvent derrière les données.